

OpenAI presentó GPT-4o, un modelo diseñado para razonar en tiempo real combinando texto, audio e imagen en una sola red neuronal. La «o» del nombre viene de «omni», y marca un cambio de enfoque frente a los modelos anteriores de la compañía, que trataban cada tipo de entrada por separado.
Un solo modelo para texto, audio e imagen
GPT-4o acepta y genera combinaciones de texto, audio e imagen con tiempos de respuesta de audio de hasta 232 milisegundos, con una media de 320. Iguala a GPT-4 Turbo en texto en inglés y código, mejora en el resto de idiomas y cuesta la mitad en la API, además de responder más rápido.
Antes de GPT-4o, el Modo de Voz de ChatGPT tenía latencias de 2,8 segundos con GPT-3.5 y de 5,4 con GPT-4, porque encadenaba tres modelos distintos para transcribir el audio, procesar el texto y convertirlo de nuevo en voz. Ese relevo entre modelos hacía perder matices como el tono o las emociones. Al entrenar un único modelo de extremo a extremo, GPT-4o procesa todas las entradas y salidas con la misma red, sin ese cuello de botella.
Qué dicen los benchmarks
En inteligencia textual, razonamiento y código, GPT-4o se sitúa al nivel de GPT-4 Turbo, pero establece nuevos máximos en capacidades multilingües, de audio y de visión. Alcanzó un 88,7% en el benchmark 0-shot COT MMLU y un 87,2% en el 5-shot no-CoT MMLU.
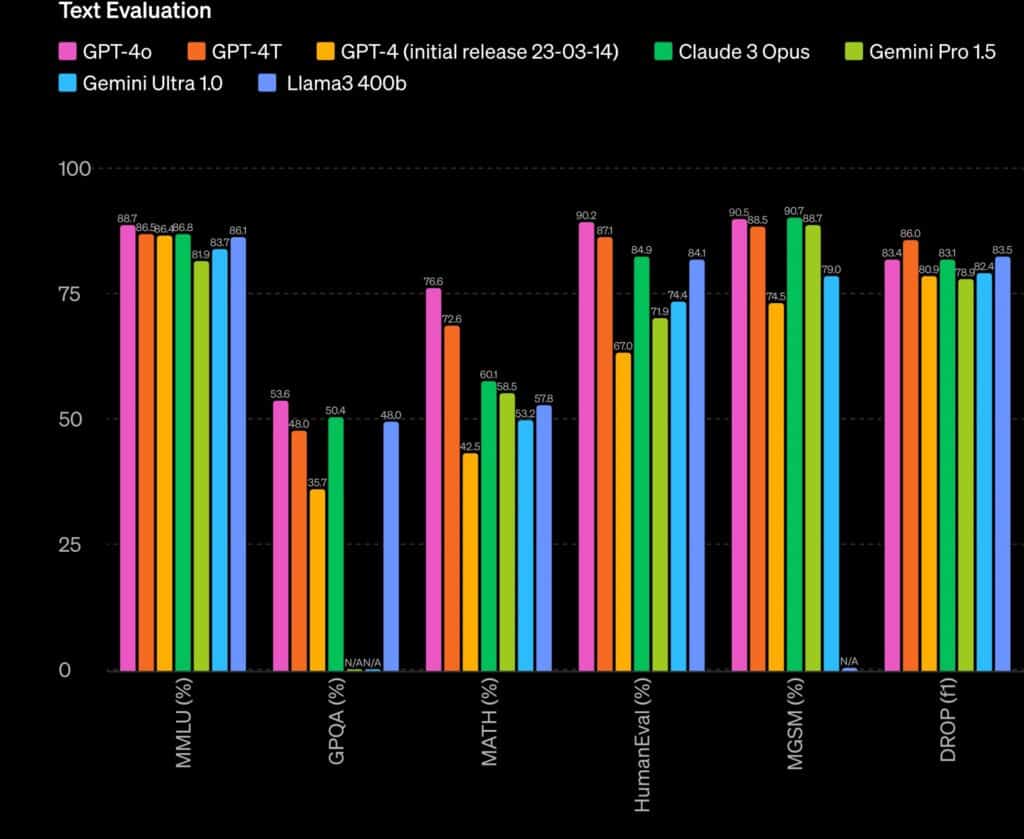
En reconocimiento de voz supera claramente a Whisper-v3 en todos los idiomas, sobre todo en los que tienen menos recursos de entrenamiento disponibles, y marca un nuevo estándar en traducción de audio en el benchmark MLS. En comprensión visual lidera pruebas como MMMU, MathVista y ChartQA.
Seguridad y límites del lanzamiento
OpenAI aplicó filtrado de datos de entrenamiento y ajustes posteriores para que las tres modalidades funcionen de forma segura, y evaluó el modelo con su Marco de Preparación, que le asigna un riesgo medio en áreas como ciberseguridad y autonomía. Más de 70 expertos externos en psicología social, equidad y desinformación participaron en las pruebas para detectar riesgos nuevos antes del lanzamiento.
La modalidad de audio es la que más riesgos nuevos introduce, así que OpenAI la lanzó por fases: primero solo texto e imagen, y después voz con timbres preestablecidos bajo las mismas políticas de seguridad que ya aplicaba en ChatGPT.
Disponibilidad
GPT-4o llegó a ChatGPT tanto en la versión gratuita como en Plus, con límites de mensajes más altos para los suscriptores. Los desarrolladores pueden usarlo vía API con texto y visión, y OpenAI anunció que las funciones de audio y vídeo llegarían después a un grupo reducido de socios.
Desde este lanzamiento, OpenAI ha seguido iterando su catálogo: meses después llegó o3-pro con mejoras en Voice, y ahora la compañía trabaja ya en lo que podría ser GPT-6, señal de lo rápido que avanza el ritmo de lanzamientos desde que GPT-4o abrió la puerta a la interacción multimodal en tiempo real.
Preguntas frecuentes
¿Qué significa la «o» de GPT-4o?
Viene de «omni», porque el modelo procesa y genera texto, audio e imagen con una única red neuronal en lugar de con modelos separados para cada tarea.
¿En qué mejora GPT-4o al Modo de Voz anterior de ChatGPT?
Reduce la latencia de los 2,8-5,4 segundos que tenía con GPT-3.5 y GPT-4 a una media de 320 milisegundos, porque ya no encadena tres modelos distintos para transcribir, procesar y generar audio.
¿Cuánto cuesta usar GPT-4o frente a GPT-4 Turbo?
Un 50% menos en la API, además de responder de forma más rápida.
¿GPT-4o está disponible para todos los usuarios de ChatGPT?
Sí, tanto en la versión gratuita como en ChatGPT Plus, con límites de mensajes más altos para los suscriptores de pago.
Más información y ejemplos en vídeo en OpenAI.