Inteligencia Artificial

Google lanza Gemini 3.8 Flash Cyber para buscar y parchear vulnerabilidades

Google ha presentado Gemini 3.8 Flash Cyber, una variante especializada de su nuevo Gemini 3.8 diseñada para localizar vulnerabilidades y generar correcciones de código de forma automatizada. El modelo no tendrá la misma disponibilidad que Gemini 3.8 Flash: Google DeepMind restringirá su acceso a defensores considerados de confianza mediante el nuevo programa Fairwind, entre ellos organismos públicos, operadores de infraestructuras
Ollama acelera los modelos de IA en Mac con MLX: hasta 134 tokens por segundo

Ollama está cambiando la forma de ejecutar modelos de inteligencia artificial en los Mac con Apple Silicon. La incorporación de MLX, el framework de aprendizaje automático desarrollado por Apple, permite aprovechar una ruta de inferencia diferente a la tradicional basada en llama.cpp. En las pruebas publicadas por Ollama, Qwen3.5-35B-A3B pasó de 58 a 112 tokens por segundo en generación, mientras

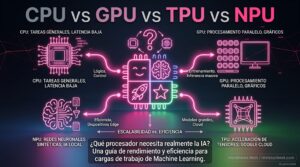
CPU, GPU, TPU y NPU: qué chips están compitiendo por ejecutar la IA

La inteligencia artificial ya no depende de un único tipo de procesador. CPU, GPU, TPU y NPU desempeñan funciones diferentes, desde coordinar un ordenador hasta entrenar grandes modelos o ejecutar IA directamente en un portátil. A ellos se suman FPGA, ASIC especializados y procesadores de infraestructura como las DPU. Entender las diferencias ayuda a explicar por qué la próxima generación

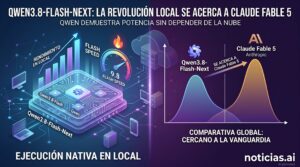
Qwen3.8-Flash-Next se acerca a Claude Fable 5 y puede ejecutarse en local

Alibaba ha publicado Qwen3.8-Flash-Next, un modelo de pesos abiertos que sirve como anticipo de la arquitectura que utilizará la futura familia Qwen4. La cifra que más llama la atención no es únicamente su tamaño: el modelo principal tiene 125.000 millones de parámetros, pero activa alrededor de 6.000 millones por token gracias a su arquitectura Mixture-of-Experts (MoE). En el Agentic Index

Un test con más de 20 modelos de IA deja una advertencia para programadores: más grande no siempre significa mejor

Elegir un modelo de inteligencia artificial para programar basándose únicamente en su número de parámetros puede llevar a resultados inesperados. Una prueba práctica realizada por el desarrollador Rost Glukhov con más de 20 modelos encontró diferencias enormes al generar código y, sobre todo, al producir información estructurada. En su experimento, una versión cuantizada de Qwen 3.5 27B obtuvo una tasa

Bill Gates pide proteger empleos humanos frente a la IA: Silicon Valley discrepa

Bill Gates ha endurecido notablemente su discurso sobre el futuro de la inteligencia artificial. En un extenso ensayo publicado esta semana, el cofundador de Microsoft sostiene que la IA puede acabar eliminando de forma permanente muchos puestos de trabajo y propone dos medidas que chocan con buena parte del discurso dominante en Silicon Valley: reservar determinadas funciones exclusivamente para personas

NVIDIA negocia la compra de Hugging Face por 12.900 millones: qué hay detrás

NVIDIA habría alcanzado un acuerdo para comprar Hugging Face por 12.900 millones de dólares, según ha adelantado The Information citando a una persona conocedora de la operación. La adquisición colocaría bajo el control del mayor fabricante de aceleradores para inteligencia artificial una de las principales plataformas utilizadas para publicar, descargar y ejecutar modelos abiertos. Sin embargo, existe una diferencia importante

El nuevo Mac mini M6 quiere convertir la IA local en un gasto de electricidad

Apple ha encontrado un nuevo argumento para vender el Mac mini a profesionales y pequeñas empresas: ejecutar inteligencia artificial de forma permanente en el propio ordenador. El nuevo modelo con chip M6 llega con un precio superior al anterior, pero también con un salto considerable en capacidad para IA y una propuesta que puede resultar atractiva para determinados negocios: sustituir

AMD compra Taalas: la apuesta por chips que graban modelos de IA en silicio

AMD ha adquirido Taalas, una compañía especializada en aceleradores de inteligencia artificial que propone una forma muy distinta de ejecutar modelos: incorporar sus pesos directamente en el silicio. Su primer chip de demostración, HC1, ha alcanzado alrededor de 16.960 tokens por segundo con Llama 3.1 8B, según las pruebas publicadas por la empresa. Más que el récord de velocidad, la

Hermes-Skills convierte los prompts de un agente de IA en capacidades reutilizables

João Silva ha publicado Hermes-Skills, un repositorio abierto con diez capacidades que utiliza para automatizar una flota de agentes basada en Hermes Agent. La idea resulta más interesante que otra colección de prompts: cada skill empaqueta instrucciones, scripts, referencias y experiencia acumulada para que un agente pueda aprender un procedimiento completo, cargarlo cuando lo necesite y reutilizarlo sin reconstruir el

Scroll al inicio