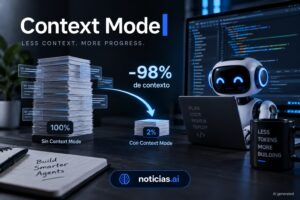


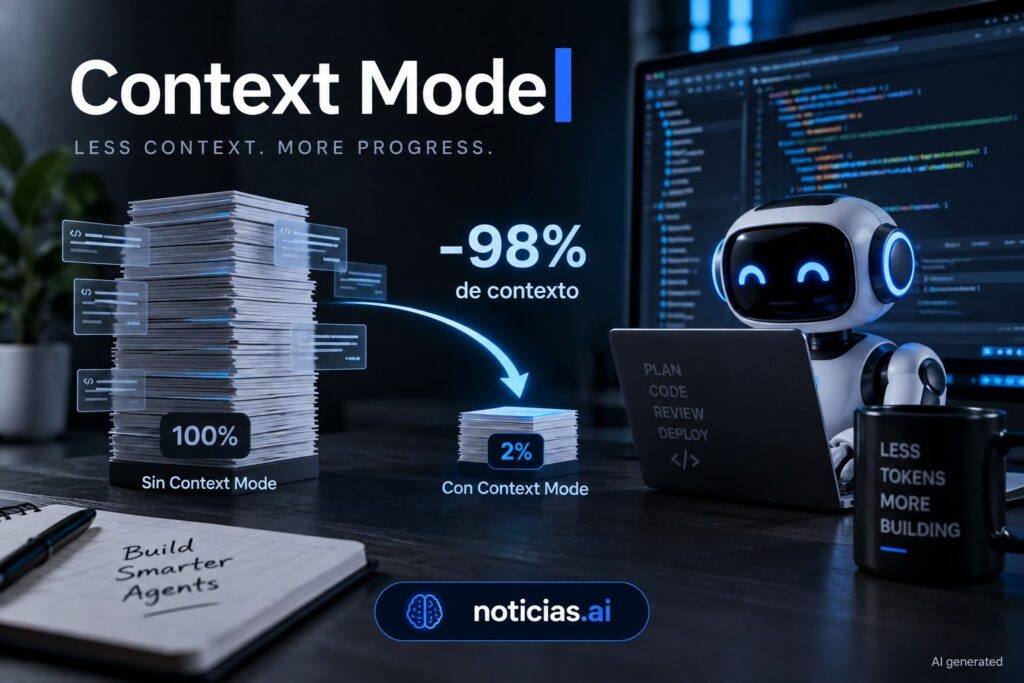
Los agentes de inteligencia artificial para programar pueden degradar su rendimiento mucho antes de alcanzar el límite nominal de contexto. El problema no siempre está en el modelo: archivos completos, logs, resultados de pruebas, snapshots de navegador o decenas de incidencias de GitHub van acumulándose en la conversación. Context Mode propone sacar esos datos del contexto del modelo, procesarlos localmente y devolver solo la información necesaria, con reducciones de hasta el 98 % en sus propios benchmarks.
Las claves de Context Mode en 20 segundos
- Context Mode intercepta salidas grandes de herramientas antes de que entren en el contexto del modelo.
- Sus pruebas reducen una sesión de 315 KB de datos brutos a 5,4 KB.
- Guarda información localmente en SQLite FTS5 y recupera solo fragmentos relevantes.
- Funciona con Claude Code, Cursor, Copilot, Codex, Gemini CLI y otros agentes.
- Es gratuito para desarrolladores, aunque utiliza licencia Elastic License 2.0.
La idea ataca una limitación que está ganando importancia a medida que los asistentes de programación dejan de responder preguntas aisladas y empiezan a trabajar durante decenas de minutos sobre repositorios completos.
Un agente puede comenzar una sesión con instrucciones relativamente pequeñas y terminar cargando resultados de grep, archivos de código, históricos de Git, errores de compilación, respuestas de API, documentación y salidas de herramientas MCP (Model Context Protocol). Parte de esa información deja de ser relevante rápidamente, pero continúa ocupando espacio y, dependiendo de la arquitectura del agente, puede volver a enviarse al modelo en turnos posteriores.
Context Mode intenta cambiar ese flujo. En lugar de entregar siempre al modelo la respuesta completa de una herramienta, ejecuta y procesa los datos fuera de su ventana de contexto y solo introduce el resultado filtrado. El proyecto muestra, por ejemplo, una reducción de 315 KB de salida acumulada a 5,4 KB durante una sesión completa, una mejora cercana al 98 % según sus propios benchmarks.
La clave no es ampliar el contexto, sino evitar llenarlo con datos innecesarios
Los grandes modelos actuales pueden manejar ventanas de contexto cada vez mayores, pero disponer de más tokens no elimina el problema de utilizarlos mal.
Un ejemplo sencillo aparece al consultar una lista grande de incidencias de GitHub. El agente quizá necesite localizar tres errores relacionados con autenticación, pero la herramienta puede devolver decenas de incidencias completas. Si todo ese contenido entra en la conversación, el modelo recibe títulos, comentarios, metadatos y fragmentos que posiblemente no vuelva a utilizar.
Context Mode introduce una capa intermedia.
Cuando una herramienta genera una salida grande, el contenido puede procesarse mediante sus herramientas ctx_execute, ctx_execute_file, ctx_index o ctx_fetch_and_index. El resultado completo permanece fuera de la conversación y el modelo recibe únicamente la salida que necesita.
El proyecto resume algunas de sus pruebas de esta forma:
| Escenario | Datos originales | Contexto enviado | Ahorro declarado |
|---|---|---|---|
| Snapshot de Playwright | 56,2 KB | 299 bytes | 99 % |
| 20 issues de GitHub | 58,9 KB | 1,1 KB | 98 % |
| Log de 500 peticiones | 45,1 KB | 155 bytes | ~100 % |
| CSV de 500 filas | 85,5 KB | 222 bytes | ~100 % |
| Salida de 30 suites de tests | 6,0 KB | 337 bytes | 95 % |
| Investigación de un repositorio | 986 KB | 62 KB | 94 % |
| Sesión completa de referencia | 315 KB | 5,4 KB | 98 % |
Son resultados publicados por el propio proyecto y no una comparación independiente entre herramientas. Aun así, sirven para explicar el enfoque: reducir la información antes de que llegue al modelo en vez de confiar únicamente en una ventana de contexto cada vez mayor.
El proyecto incluso plantea una forma diferente de trabajar con grandes cantidades de datos: hacer que el modelo escriba código que los analice.
Si el objetivo consiste en contar funciones dentro de 50 archivos, por ejemplo, no tendría sentido cargar los 50 documentos completos en la conversación para que el modelo los inspeccione. Context Mode propone ejecutar un pequeño programa local que realice el recuento y devolver únicamente el resultado.
Es un cambio aparentemente pequeño, pero puede evitar cientos de kilobytes de contexto en tareas repetitivas.
SQLite, FTS5 y BM25 para recuperar solamente lo que vuelve a hacer falta
Context Mode no se limita a descartar información.
Los datos que pueden resultar útiles posteriormente se indexan localmente utilizando SQLite FTS5, el sistema de búsqueda de texto completo integrado en SQLite. Cuando el agente necesita recuperar información, realiza una consulta y obtiene fragmentos relacionados con lo que está buscando.
El proyecto utiliza BM25 para ordenar resultados y combina búsquedas basadas en palabras con coincidencias por trigramas. También incorpora corrección de errores tipográficos y un sistema de extracción de fragmentos que intenta mostrar la sección relevante en lugar de devolver el principio completo de un documento.
La arquitectura busca resolver uno de los problemas más incómodos de los agentes de código: la compactación de conversaciones.
Cuando un agente agota buena parte de su ventana disponible puede resumir el historial para liberar espacio. Ese proceso permite seguir trabajando, pero también corre el riesgo de perder detalles sobre archivos modificados, errores pendientes, decisiones del usuario o tareas todavía abiertas.
Context Mode mantiene esos eventos en una base de datos SQLite asociada al proyecto. Antes de una compactación puede preparar un estado de la sesión y posteriormente recuperar la información relevante.
Según su documentación, registra elementos como operaciones sobre archivos, acciones de Git, tareas, errores y decisiones tomadas durante la sesión. No vuelve a insertar toda la base de datos en el prompt: la información permanece indexada y se recupera cuando resulta necesaria.
Esto permite separar dos conceptos que suelen mezclarse cuando se habla de «memoria» en un agente:
| Problema | Qué intenta hacer Context Mode |
|---|---|
| Demasiados datos en la ventana | Procesarlos fuera del contexto |
| Volver a necesitar información antigua | Buscarla en el índice local |
| Compactación de la conversación | Conservar el estado de la sesión |
| Grandes salidas de herramientas | Filtrarlas antes de enviarlas |
| Análisis de muchos archivos | Ejecutar código local y devolver resultados |
El planteamiento guarda cierta relación con los sistemas RAG (Retrieval-Augmented Generation), aunque aplicado a la propia actividad del agente. No se pretende que el modelo mantenga cada dato visible permanentemente, sino que pueda recuperarlo cuando lo necesite.
Claude Code tiene la integración más completa, pero no es el único compatible
Context Mode se presenta actualmente con soporte para 17 adaptadores.
Entre ellos aparecen Claude Code, Gemini CLI, Cursor, GitHub Copilot CLI, VS Code Copilot, JetBrains Copilot, OpenCode, KiloCode, OpenClaw, Codex CLI, Kimi Code, Kiro, Zed, Pi Coding Agent y OMP, entre otros.
No todas las integraciones ofrecen las mismas capacidades.
Claude Code puede instalar Context Mode como plugin y dispone de hooks que interceptan automáticamente distintos momentos de la sesión. El proyecto utiliza mecanismos como PreToolUse, PostToolUse, PreCompact, SessionStart y Stop para decidir cuándo redirigir una operación, registrar eventos o restaurar el estado.
En otras herramientas las capacidades dependen de los hooks que permita cada cliente.
Por ejemplo, la documentación indica que algunas integraciones pueden interceptar llamadas a herramientas pero no restaurar completamente una sesión después de una compactación. En clientes sin soporte para hooks, la herramienta depende en mayor medida de instrucciones incluidas en archivos como AGENTS.md o GEMINI.md.
Esta diferencia importa. La propia documentación estima ahorros cercanos al 98 % cuando puede aplicar el enrutamiento mediante hooks, mientras sitúa alrededor del 60 % el ahorro orientativo cuando depende únicamente de instrucciones al modelo. Son nuevamente cifras del proyecto, no garantías para cualquier repositorio o carga de trabajo.
Para Claude Code, la instalación propuesta utiliza su sistema de plugins:
/plugin marketplace add mksglu/context-mode
/plugin install context-mode@context-mode
Después puede comprobarse el funcionamiento mediante ctx-doctor y consultar los ahorros de una sesión con ctx-stats.
El proyecto es gratuito, pero ELv2 no equivale exactamente a una licencia open source tradicional
Hay un detalle que conviene precisar porque la propia web utiliza en algunos lugares la expresión open-source plugin.
El código está disponible públicamente en GitHub y el plugin para desarrolladores se puede utilizar gratuitamente, pero su licencia es Elastic License 2.0 (ELv2). El repositorio explica que permite usar, copiar, modificar y distribuir el software, pero prohíbe ofrecer una parte sustancial de sus funcionalidades como servicio alojado o gestionado para terceros.
Por eso resulta más preciso describirlo como software de código disponible públicamente o source-available que como proyecto open source bajo una licencia tradicional aprobada por la Open Source Initiative.
Context Mode tiene además una vertiente comercial independiente del plugin local.
La compañía ofrece Context Mode Platform, orientada a organizaciones de ingeniería, por 20 dólares por usuario y mes. Su propuesta consiste en utilizar eventos estructurales generados por el plugin para ofrecer información sobre sesiones, errores, trabajo repetido y utilización de herramientas de IA.
Según la empresa, la plataforma recibe metadatos estructurales y no el código fuente, los prompts ni el contenido de los archivos. Esta capa es opcional: el plugin gratuito puede funcionar localmente sin una cuenta ni la plataforma comercial.
La web del proyecto también muestra cifras de adopción y decenas de miles de estrellas en GitHub. Son métricas dinámicas y cambian rápidamente, por lo que resulta más útil fijarse en el diseño técnico que en el contador concreto.
El interés de Context Mode está precisamente en que aborda un problema que probablemente crecerá con los agentes de programación de larga duración. Aumentar de 200.000 a 500.000 o un millón de tokens la ventana disponible sirve de poco si una parte considerable acaba ocupada por logs, resultados repetidos y documentos que el modelo ya no necesita consultar directamente.
El enfoque contrario consiste en tratar el contexto como un recurso limitado: guardar fuera los datos voluminosos, buscarlos cuando hagan falta y entregar al modelo únicamente la porción necesaria para tomar la siguiente decisión.
Ese diseño no aumenta la inteligencia del modelo ni garantiza que un agente programe mejor. Pero sí puede conseguir que llegue mucho más lejos en una sesión antes de empezar a perder información útil entre miles de tokens de ruido.