

El mercado de la inteligencia artificial sigue evolucionando rápidamente, y con ello, la presión sobre la memoria GPU está en aumento. Modelos cada vez más grandes, con contextos más largos y aplicaciones autónomas están incrementando la demanda de memoria, justo en un momento en que el suministro de GPUs se encuentra ajustado y los precios en alza. Se anticipa que esta tendencia continúe en el futuro cercano.
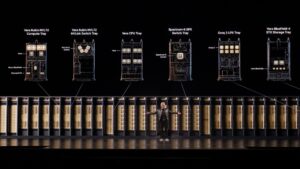
NVIDIA, un nombre prominente en el mundo de la computación acelerada, ha estado a la vanguardia en la adopción de tecnologías de memoria de última generación. Ha sido la primera en aprovechar las tecnologías HBM3e y HBM4, integrándolas en su pila de computación acelerada. No obstante, la estrategia de NVIDIA va más allá de simplemente añadir más memoria a sus GPUs. La compañía diseña sus GPUs, CPUs, redes, almacenamiento y software de manera integral para maximizar el rendimiento de cada capa de memoria en lo que ellos llaman la «fábrica de IA». Este enfoque resalta la importancia de una jerarquía de memoria y almacenamiento eficiente en las operaciones de inteligencia artificial, donde la memoria de alta velocidad (HBM) es el recurso más rápido, costoso y disputado.
A medida que los modelos de IA avanzados alcanzan trillones de parámetros, la necesidad de un almacenamiento eficiente para cachés de KV (clave-valor) y otros datos contextuales se vuelve crítica. Estas cachés, que almacenan la información necesaria para comprender cada solicitud activa sin reprocesar datos repetidos, están expandiéndose. Además, las trayectorias automáticas llevan el contexto previo en llamadas repetidas de modelos y herramientas, incrementando la carga de memoria de trabajo con el tiempo. La generación aumentada por recuperación (RAG) agrega información empresarial relevante a las instrucciones, incrementando aún más el contexto a procesar y retener.
Durante la inferencia, la HBM debe retener tanto los parámetros del modelo como las cachés de KV, lo que genera una presión adicional. Aumentar la capacidad de HBM por GPU podría parecer la solución evidente, pero solo resulta eficaz hasta el punto en que la capacidad de mover datos iguala la disponibilidad de memoria. Una vez alcanzada la «pared de la memoria», donde la velocidad de procesamiento no puede compensar el flujo de datos, la capacidad adicional no mejora el rendimiento y genera costos innecesarios y consumo de energía.
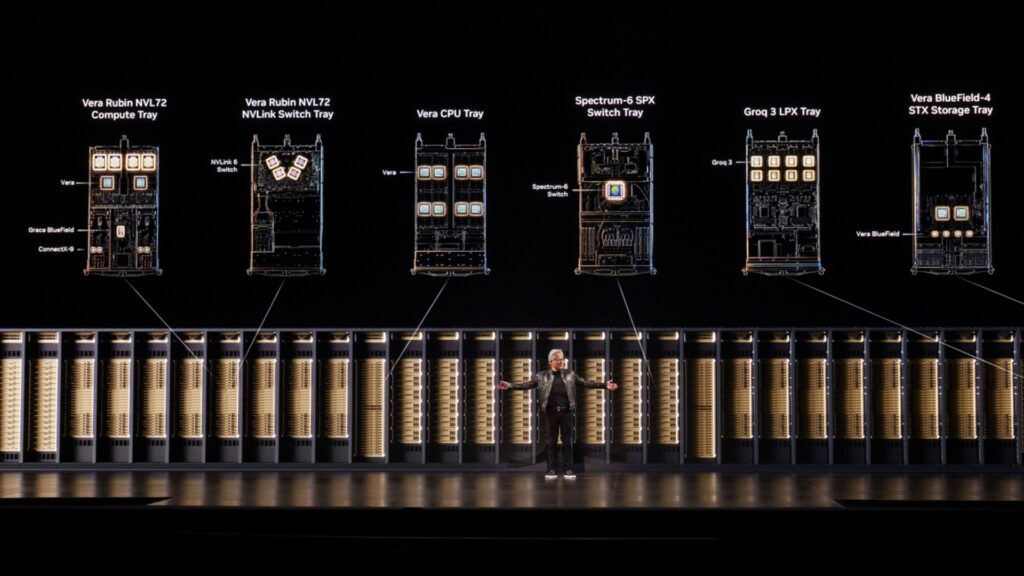
Para sortear estas limitaciones, NVIDIA se apoya en un diseño integral de su pila tecnológica que busca maximizar el valor de cada byte. Optimizando el uso de HBM, la empresa aplica diversas técnicas para disminuir el espacio necesario para los parámetros del modelo y redistribuirlos eficientemente. Además, la empresa mejora la eficacia mediante la reducción del tamaño de las cachés de KV y la reubicación de contextos inactivos a capas de almacenamiento más económicas, como el almacenamiento de memoria de contexto NVIDIA CMX, que optimiza la reutilización del contexto a escala.
Gracias a estas estrategias de diseño, NVIDIA ha logrado mejorar el rendimiento de sus plataformas de manera considerable. Las generaciones sucesivas de plataformas NVIDIA han demostrado aumentos significativos en la producción útil por dólar, con la plataforma GB300 NVL72 alcanzando hasta 10 veces más rendimiento por dólar que sus predecesoras, y Vera Rubin NVL72 llegando a mejorar este rendimiento hasta 30 veces más.
Para los operadores de fábricas de IA, la métrica crucial es cuántos tokens útiles pueden entregar dentro de un presupuesto energético controlado mientras satisfacen las necesidades de tiempo de respuesta de los usuarios. Más tokens por segundo por vatio se traducen en más trabajo y más ingresos con el mismo consumo energético, reduciendo el costo por token. El diseño integral de NVIDIA potencia la entrega de trabajo útil por cada byte de memoria, reafirmando su liderazgo en innovación tecnológica para el futuro de la inteligencia artificial.
Fuente: Zona de blogs y prensa de Nvidia