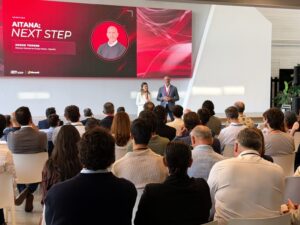


Revolut ha convertido un modelo de pesos abiertos de la familia GLM, del laboratorio chino Z.ai, en el asistente de programación por defecto de unos 2.000 ingenieros, y ha dejado Claude Code y Codex como opciones de excepción. Según David Abitbol, responsable de operaciones de IA de la fintech, desde que en abril de 2026 empezó a servir ese modelo en capacidad dedicada, el tiempo de programación ha mejorado un 60 % y el lead time de ingeniería, el tiempo que tarda un cambio en llegar a producción, un 70 %.
Las claves del cambio de modelo en Revolut en 20 segundos
- Unos 2.000 ingenieros de Revolut programan por defecto con un modelo GLM de Z.ai.
- Claude Code y Codex siguen disponibles, pero solo como excepción.
- La empresa declara mejoras del 60 % en tiempo de programación y del 70 % en lead time.
- Nadie ha medido de forma independiente cuánto se debe al modelo y cuánto a otros cambios.
Los datos salen de una charla de Abitbol que el canal AI Engineer publicó el 29/10/2026 y que han recogido StartupHub.ai y AIChatDaily. El agregador daily.dev la resumió después a partir de varias fuentes. No se ha localizado una publicación propia de Abitbol en LinkedIn o X con las cifras, de modo que todas proceden de la empresa. La parte de infraestructura, con 56 GPU (unidades de procesamiento gráfico) NVIDIA B200 y un coste declarado de 0,30 dólares por millón de tokens, la ha analizado Revista Cloud en su pieza sobre el coste real de la inferencia propia de Revolut.
Tokens sin racionar: lo que cambió en el día a día de los ingenieros
La charla describe una evolución en tres etapas. A principios de 2025, con Gemini, Revolut midió una mejora de alrededor del 10 % en lead time y del 20 % en tiempo de programación. Después llegó Claude Code, pero con límites estrictos de presupuesto por ingeniero, y el efecto fue escaso según la propia empresa. La tercera etapa, con GLM servido en capacidad dedicada desde abril de 2026, es la que coincide con las mejoras del 60 % y el 70 %.
La diferencia entre la segunda y la tercera etapa no está solo en el modelo. Con un coste por token mucho menor, Revolut dejó de racionar el uso. Esa es la lectura de @guilleflorvs, el usuario que dio primero la noticia en X: según recoge daily.dev, la mejora llegó cuando se dejaron de racionar los tokens. El gráfico que mostró Abitbol, además, no separa el efecto del cambio de modelo del de otros cambios simultáneos, así que la cifra mide el conjunto y no al modelo por sí solo.
Abitbol también apuntó una idea que matiza el entusiasmo por los asistentes de código. Según AIChatDaily, dijo en inglés que «el cuello de botella de la ingeniería no está necesariamente en programar». Es coherente con que el lead time, que incluye revisión, pruebas y despliegue, haya mejorado más que el tiempo de escritura de código.
En cuanto a herramientas, StartupHub.ai explica que el modelo expone una API compatible con la de OpenAI y que los ingenieros lo usan a través de OpenCode y de Codex como entornos de trabajo. Cada ejecución de un agente tiene supervisión humana y corre en un entorno aislado con listas de comandos permitidos: un git add se acepta, pero las órdenes destructivas quedan bloqueadas. Las tareas con imágenes no pasan por GLM y se envían a Gemini o a GPT-6 Luna, el modelo económico que OpenAI lanzó el 22/09/2026.
Modelo abierto frente a frontera: lo que se sabe y lo que no
daily.dev identifica el modelo como GLM-5.3, el que Z.ai lanzó por API el 14/08/2026 y cuyos pesos publicó el 29/08/2026, como ya contó Noticias.ai cuando Z.ai preparaba GLM-5.3 para recortar distancias en código. Es un modelo de mezcla de expertos con 744.000 millones de parámetros totales y 40.000 millones activos por token. Otras crónicas no precisan la versión, y un caso publicado por Together AI sobre «una fintech global», sin nombre, con las mismas 56 B200, habla de GLM-5.2. Revolut empezó en abril, antes de que existiera GLM-5.3, así que, si hoy usa esa versión, el modelo de producción ha cambiado al menos una vez.
Lo que no existe es una comparación pública de calidad. Ni Revolut ha publicado tasas de errores, revisiones rechazadas o incidencias antes y después del cambio, ni hay evaluaciones independientes de su caso. El debate sobre si un modelo abierto iguala a Claude Opus 5.5 o a GPT-6 Sol en programación se apoya hoy en opiniones y en pruebas de terceros, no en datos de esta empresa.
Hay, eso sí, lecciones técnicas. Según StartupHub.ai, Abitbol calificó el contexto largo de «estafa para esta carga de trabajo» (traducido del inglés), y Revolut lo limitó a 256.000 tokens. AIChatDaily añade que el objetivo es mantener por encima del 90 % la tasa de aciertos de caché en trabajo de programación, algo que pesa tanto en el coste como en la velocidad de respuesta.
Qué debería plantearse otra empresa antes de copiarlo
La primera cuestión es la escala. Revolut, que en julio de 2026 confirmó una venta secundaria de acciones con una valoración publicada de 115.000 millones de dólares, puede sostener un equipo que afine y opere decenas de GPU. daily.dev recuerda que mantener 56 B200 exige personal propio y que ese coste reduce el ahorro, por lo que lo previsible es que las startups sigan usando API (interfaces de programación) de terceros.
La segunda es el precio de comparación. A 05/11/2026, Claude Sonnet 5.5 cuesta 2 dólares por millón de tokens de entrada y 10 de salida, Claude Opus 5.5 cuesta 4 y 20, y GPT-6 Sol, 2 y 10, con lecturas de caché mucho más baratas en los tres. Con esos precios, el «una décima parte» que declara Revolut es verosímil, pero depende de su mezcla de entrada, salida y caché, que no ha publicado. Quien quiera hacer la misma cuenta necesita sus propios datos de consumo, y también una referencia de partida: sin medir antes el lead time, no hay forma de saber qué aporta el cambio. Para quien siga con API, hay técnicas para aprovechar Claude Code sin quemar tokens que atacan el mismo problema por otra vía.
La tercera es la licencia y el cumplimiento normativo. La licencia de GLM-5.3 es propia, no MIT, y según IntuitionLabs exige una revisión de seguridad de Z.ai a los operadores que ofrezcan el modelo como servicio y superen 10.000 millones de dólares de ingresos agregados. En el caso de un banco con licencia en Reino Unido, además, no se han encontrado declaraciones de los supervisores sobre el uso de modelos de laboratorios chinos, de modo que la pregunta sigue abierta. StartupHub.ai detalla que Revolut mantiene la inferencia en países con equivalencia en protección de datos y con proveedores que no retienen información por defecto.
El caso también alimenta una discusión de fondo. @omarsar0 sostiene, según recoge daily.dev, que cada empresa debe ser dueña de su propio stack de inteligencia, y @guilleflorvs plantea que, si los modelos de frontera pasan a ser la excepción, los laboratorios que preparan su salida a bolsa tendrán un problema de precios. Son opiniones, no mediciones.
Preguntas frecuentes
¿Qué asistente de programación usa Revolut?
Por defecto, un modelo de pesos abiertos GLM de Z.ai, que los ingenieros usan a través de OpenCode y Codex. El uso de Claude Code y Codex con los modelos de Anthropic y OpenAI queda como excepción.
¿Cuánto ha mejorado la productividad en Revolut?
La empresa declara una mejora del 60 % en tiempo de programación y del 70 % en lead time desde abril de 2026. Su propio gráfico no separa el efecto del modelo del de otros cambios simultáneos.
¿Por qué Revolut no notó mejoras con Claude Code al principio?
Según la charla de Abitbol, Claude Code se desplegó con límites estrictos de presupuesto de tokens y su impacto fue escaso.
¿Puede una startup hacer lo mismo?
Es poco probable a corto plazo, porque mantener 56 GPU B200 exige un equipo propio y ese coste reduce el ahorro.
Fuentes: Revista Cloud, StartupHub.ai, AIChatDaily, Together AI, Gigazine, IntuitionLabs, Tech.eu, Precios de la API de Claude, Implicator y daily.dev (resumen «Revolut moves about 2,000 engineers to self-hosted GLM for coding»).