

Ejecutar modelos de inteligencia artificial en local ya no consiste únicamente en elegir la tarjeta gráfica con más potencia. En 2026, una GeForce RTX 5090 ofrece 32 GB de GDDR7 y un ancho de banda de 1.792 GB/s, mientras que equipos como AMD Strix Halo, NVIDIA DGX Spark y los nuevos Mac Studio con M5 Max y M5 Ultra apuestan por grandes cantidades de memoria unificada. La diferencia determina qué modelos caben, a qué velocidad pueden responder y cuánto cuesta realmente montar el equipo.
Las claves de la IA local en 20 segundos
- La RTX 5090 tiene 32 GB y 1.792 GB/s de ancho de banda.
- Strix Halo y DGX Spark llegan a 128 GB, pero rondan 256-273 GB/s.
- El M5 Max alcanza 128 GB y 614 GB/s; el M5 Ultra llega a 512 GB y 1,2 TB/s.
- En septiembre, una RTX 5090 puede superar los 5.000 € en el mercado europeo.
- El precio oficial de la 5090 sigue en 2.099 €, pero conseguirla a esa cifra es otra cuestión.
La comparativa de partida plantea una cuestión que cada vez afecta a más desarrolladores, investigadores y usuarios que ejecutan modelos grandes en su propio ordenador: ¿es mejor tener menos memoria a mucha velocidad o mucha más memoria a menor velocidad? La respuesta cambia según el modelo, la cuantización, el contexto y el software utilizado.
Cuatro arquitecturas para una misma necesidad
Estas son las principales diferencias entre las máquinas analizadas:
| Máquina | Memoria | Ancho de banda aprox. | Entorno de IA | Formato |
|---|---|---|---|---|
| NVIDIA RTX 5090 | 32 GB GDDR7 | 1.792 GB/s | CUDA | Tarjeta PCIe |
| AMD Ryzen AI Max+ 395 | Hasta 128 GB LPDDR5X | 256 GB/s | ROCm, Vulkan, llama.cpp | Mini-PC, sobremesa o portátil |
| NVIDIA DGX Spark | 128 GB LPDDR5X | 273 GB/s | CUDA, Blackwell | Miniordenador de sobremesa |
| Apple M5 Max | Hasta 128 GB unificada | Hasta 614 GB/s | MLX, Apple Silicon | Mac Studio |
| Apple M5 Ultra | Hasta 512 GB unificada | 1,2 TB/s | MLX, Apple Silicon | Mac Studio |
La RTX 5090 juega en otra categoría cuando el modelo cabe completamente en sus 32 GB. NVIDIA especifica 21.760 núcleos CUDA, 32 GB de GDDR7, bus de 512 bits y 575 W de potencia gráfica total. El ancho de banda alcanza 1.792 GB/s.
El Ryzen AI Max+ 395 de AMD, conocido durante su desarrollo como Strix Halo, utiliza memoria LPDDR5X-8000 y admite hasta 128 GB. AMD cifra su ancho de banda en 256 GB/s y permite asignar hasta 96 GB como memoria gráfica mediante Variable Graphics Memory.
DGX Spark utiliza el superchip GB10 Grace Blackwell y ofrece 128 GB de memoria LPDDR5X unificada. NVIDIA especifica 273 GB/s de ancho de banda, 20 núcleos Arm, 6.144 núcleos CUDA y hasta 1 PFLOP de rendimiento FP4. La compañía sitúa el sistema como una plataforma capaz de trabajar con modelos de hasta 200.000 millones de parámetros, aunque que un modelo quepa en memoria no significa que vaya a ejecutarse a una velocidad comparable a una GPU de alto ancho de banda.
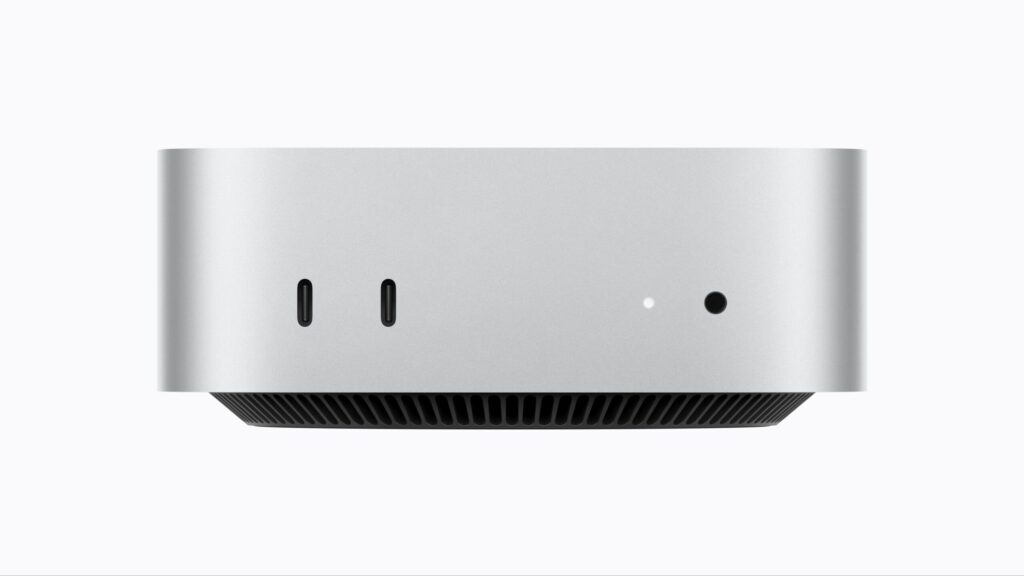
Apple presenta un escenario intermedio. El M5 Max puede configurarse con hasta 128 GB de memoria unificada y, en su versión de 40 núcleos gráficos, alcanza 614 GB/s. El M5 Ultra sube hasta 512 GB y 1,2 TB/s.
La diferencia de ancho de banda explica buena parte del comportamiento de estos equipos. La 5090 dispone de unas siete veces más ancho de banda que un Ryzen AI Max+ 395, mientras que el M5 Max supera en más del doble a Strix Halo y DGX Spark.
Los precios en euros cambian bastante la comparación
El precio es ahora una parte importante de la historia. La RTX 5090 tiene una referencia oficial europea de 2.099 €, pero las unidades disponibles en el mercado se están vendiendo muy por encima.
Un comparador europeo situaba recientemente las RTX 5090 más baratas alrededor de 5.299 €, con modelos ASUS desde 5.434,65 €. Algunas variantes de fabricantes y vendedores de marketplace superaban ampliamente los 7.000 €.
La siguiente tabla separa el precio recomendado de la tarjeta de los precios de sistemas completos. No son productos equivalentes, por lo que comparar únicamente el precio final puede resultar engañoso.
| Opción | Memoria | Precio de referencia en euros | Qué incluye |
|---|---|---|---|
| RTX 5090 Founders Edition | 32 GB | 2.099 € MSRP | Solo GPU |
| RTX 5090, mercado europeo | 32 GB | Desde ~5.299 € observado | Solo GPU |
| Framework Desktop Max+ 395 | 128 GB | 3.889 € base | Sistema, sin SSD y otros extras |
| ASUS ROG Flow Z13 | 128 GB | 4.099,99 € | Portátil completo, 1 TB SSD |
| NVIDIA DGX Spark | 128 GB | 4.800 € | Sistema completo, 4 TB |
| Mac Studio M5 Max | 128 GB | 5.859 € | Configuración europea con 512 GB SSD |
| Mac Studio M5 Ultra | 256 GB | 10.999 € | Configuración con 1 TB SSD |
La configuración europea del Framework Desktop Max+ 395 con 128 GB aparece actualmente en 3.889 € antes de añadir almacenamiento, sistema operativo, ventilador, cable y otros elementos. La compañía permite configurar hasta 128 GB de LPDDR5X-8000 y anuncia además una futura configuración de 192 GB.
El ASUS ROG Flow Z13 con Ryzen AI Max+ 395, 128 GB de LPDDR5X y 1 TB de SSD aparece en la tienda española de ASUS por 4.099,99 €.
NVIDIA fija en 4.800 € el precio mostrado actualmente para DGX Spark en su marketplace europeo, aunque la unidad aparece sin stock en la consulta realizada.
En Apple, el Mac Studio M5 Max parte de 3.029 € en España, mientras que el M5 Ultra comienza en 6.649 €. Las configuraciones con más memoria suben rápidamente: una configuración europea de M5 Max con 128 GB y 512 GB de SSD aparece en 5.859 €, mientras que el M5 Ultra de 256 GB parte de 10.999 €.
32 GB rápidos contra 128 GB de memoria unificada
Aquí aparece la diferencia que más afecta a la IA local.
Un modelo que cabe por completo en los 32 GB de la RTX 5090 puede aprovechar sus 1.792 GB/s. En modelos de tamaño medio, ese ancho de banda puede traducirse en una generación mucho más rápida que en equipos con memoria unificada más lenta.
Pero cuando el modelo no cabe, la situación cambia. El usuario puede reducir la cuantización, disminuir el contexto, utilizar técnicas de compresión o trasladar parte del modelo a otra zona de memoria. Cada una de estas opciones introduce compromisos.
Los sistemas de 128 GB reducen ese problema. Pueden mantener modelos mucho mayores en memoria y reservar espacio para una caché KV más grande, varios modelos o contextos extensos.
El precio de esa capacidad es la velocidad de memoria. DGX Spark tiene 273 GB/s frente a los 1.792 GB/s de la RTX 5090. Strix Halo se queda en 256 GB/s. El M5 Max cambia considerablemente la relación al alcanzar 614 GB/s y el M5 Ultra llega a 1,2 TB/s.
Por eso 128 GB no deben interpretarse como una versión cuatro veces mayor de los 32 GB de una 5090. Son arquitecturas diferentes.
Qué ocurre con los modelos de IA grandes
La tabla de partida utiliza varios modelos para mostrar esta diferencia:
| Modelo o clase | RTX 5090 32 GB | Strix Halo 128 GB | DGX Spark 128 GB | Mac Studio M5 |
|---|---|---|---|---|
| Qwen ~27B | Encaja bien | Encaja, menor velocidad | Encaja, menor velocidad | Encaja bien |
| MoE ~35B | Encaja bien | Encaja | Encaja | Encaja bien |
| Modelo denso ~70B | Limitado por memoria | Cabe con menor velocidad | Cabe con menor velocidad | Cabe según configuración |
| MoE ~122B | No en una sola tarjeta | Posible | Posible | Posible con 128 GB |
| Modelos MoE muy grandes | Fuera de 32 GB | Depende de cuantización | Especialmente orientado a esta clase | Especialmente interesante con 128 GB o más |
Esta tabla debe leerse como una comparación orientativa del documento de partida, no como un benchmark controlado entre las cinco plataformas. El rendimiento real cambia con la cuantización, el motor de inferencia, el contexto, la caché KV y el número de usuarios.
Los resultados publicados por diferentes comunidades muestran precisamente esa dispersión. Por ejemplo, pruebas independientes recientes con Qwen3.8-27B han registrado alrededor de 86-95 tokens por segundo en una RTX 5090, mientras que otras mediciones con M5 Max y Strix Halo utilizan configuraciones diferentes y no permiten una comparación directa.
En DGX Spark también aparecen diferencias importantes entre modelos densos y Mixture of Experts (MoE). Una medición reciente recoge 10,7 tokens por segundo para Qwen3 32B denso y 89,3 tokens por segundo para Qwen3 30B-A3B MoE bajo condiciones distintas. Eso muestra por qué el número total de parámetros de un modelo no basta para anticipar su comportamiento.
El software puede decidir tanto como el hardware
La elección tampoco termina en las especificaciones.
La RTX 5090 tiene una ventaja evidente para quienes utilizan CUDA. El ecosistema de NVIDIA incluye CUDA, TensorRT-LLM y una amplia variedad de herramientas para inferencia y desarrollo.
DGX Spark conserva esa ventaja dentro de una máquina con memoria unificada. NVIDIA ofrece 128 GB de memoria coherente y su pila DGX OS, además de soporte para PyTorch y TensorRT-LLM.
AMD ha avanzado en soporte para Ryzen AI Max+ 395. La documentación actual de ROCm incluye oficialmente el chip en sus matrices de compatibilidad para Linux y Windows, aunque AMD también señala limitaciones: en Windows, el conjunto completo de ROCm todavía no está disponible y algunas cargas de LLM pueden mostrar un rendimiento inferior al esperado.
Apple juega con otra pila. MLX está diseñado específicamente para Apple Silicon y permite trabajar con modelos locales utilizando la memoria unificada. El M5 Max, además, dispone de una cifra de ancho de banda muy superior a la de Strix Halo y DGX Spark.
Eso hace que la elección entre las máquinas no sea solamente una cuestión de gigabytes. También es una elección entre CUDA, ROCm/Vulkan y MLX, junto con las herramientas que ya utiliza cada desarrollador.
El contexto largo vuelve a cambiar las reglas
La memoria también importa cuando aumenta el contexto.
Un modelo que funciona perfectamente con 8.000 o 16.000 tokens puede necesitar mucha más memoria cuando se utiliza con 128.000 o 256.000 tokens. La caché KV crece y compite por espacio con los pesos del modelo.
Por eso una RTX 5090 puede ser una máquina muy rápida para modelos que encajan en sus 32 GB y, al mismo tiempo, resultar poco práctica para determinados modelos grandes con contexto muy extenso.
Los sistemas de 128 GB tienen más margen. Y el M5 Max añade una característica relevante: sus 614 GB/s están muy por encima de los 256-273 GB/s de Strix Halo y DGX Spark. El M5 Ultra lleva esta idea hasta 1,2 TB/s y 256 o 512 GB de memoria.
Apple ya ofrece oficialmente la configuración de 512 GB para el M5 Ultra, aunque la disponibilidad está prevista para finales de octubre.
El resultado es que la frontera entre «GPU rápida» y «ordenador capaz de ejecutar modelos enormes» se está difuminando. La memoria deja de ser únicamente un componente auxiliar y pasa a determinar qué modelos pueden permanecer residentes y qué tipo de sesiones de IA local son viables.
La comparación también explica por qué una tarjeta de 5.000 € puede no ser equivalente a un ordenador completo de 4.000 €. La primera concentra una enorme cantidad de ancho de banda en 32 GB, mientras que el segundo dedica una parte mucho mayor del presupuesto a capacidad de memoria y al resto del sistema.
Para quien trabaja principalmente con modelos de 20.000-35.000 millones de parámetros, una GPU rápida puede ofrecer una experiencia muy distinta. Para quien necesita modelos de 70.000, 120.000 millones o grandes MoE, la capacidad de memoria pasa a ser el primer filtro.
Y para quienes quieren ambas cosas, el M5 Max y, sobre todo, el M5 Ultra introducen una tercera posibilidad: mucha memoria sin renunciar a un ancho de banda considerable. El coste, sin embargo, aumenta con rapidez.
En 2026, por tanto, comprar hardware para IA local exige decidir primero qué modelos se quieren ejecutar y con qué contexto. Después llega la elección del hardware. La cifra de memoria es importante, pero por sí sola no dice a qué velocidad funcionará un modelo ni cuánto costará realmente mantenerlo en producción.
Preguntas frecuentes
¿Cuánta memoria tiene la RTX 5090?
La GeForce RTX 5090 incorpora 32 GB de memoria GDDR7 y ofrece un ancho de banda de 1.792 GB/s.
¿Cuánto cuesta una RTX 5090 en Europa?
El precio recomendado actual es de 2.099 €, pero las ofertas de mercado consultadas en septiembre de 2026 parten de aproximadamente 5.299 € en algunos comparadores.
¿Qué equipos ofrecen 128 GB de memoria para IA local?
Entre las opciones analizadas están los sistemas con Ryzen AI Max+ 395, NVIDIA DGX Spark y Mac Studio con M5 Max. El Mac Studio M5 Ultra amplía la capacidad hasta 256 o 512 GB.
¿Qué Mac Studio tiene más memoria?
El Mac Studio con M5 Ultra admite hasta 512 GB de memoria unificada. La configuración de 512 GB está prevista para finales de octubre de 2026.
vía: Rost Glukhov