

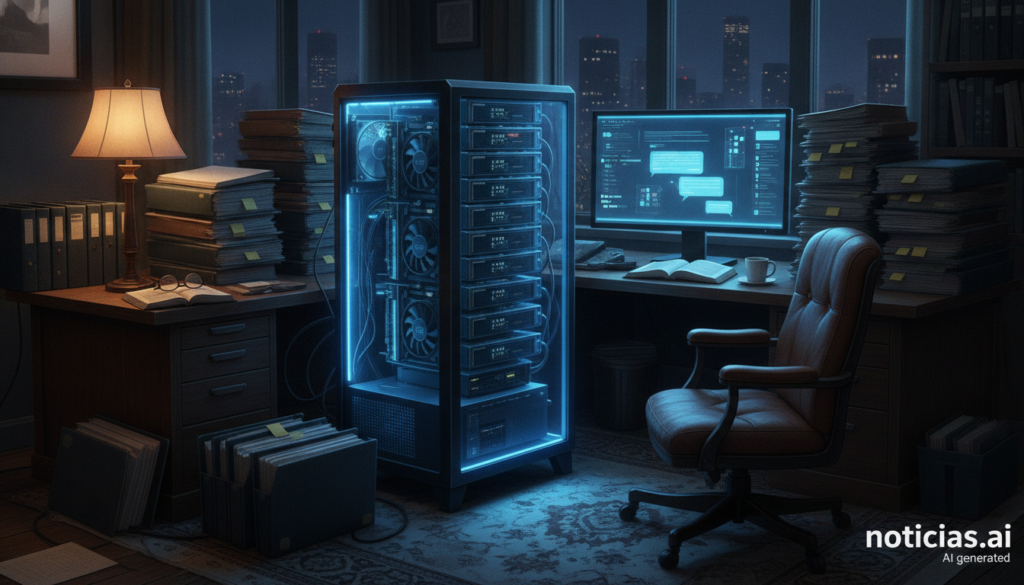
Un abogado estadounidense ha montado en su oficina un servidor de inteligencia artificial con ocho tarjetas NVIDIA Tesla V100 de segunda mano para ejecutar en local el modelo DeepSeek V4.1 Flash y procesar expedientes jurídicos sin que los documentos salgan del despacho. Según sus cuentas, las GPU y las placas le costaron unos 4.800 dólares. Ha documentado el proyecto en el foro r/homelab de Reddit, bajo el usuario TumbleweedNew6515, y en un repositorio de GitHub con la configuración y sus pruebas de rendimiento.
Las claves del servidor de IA privado del abogado en 30 segundos
- Usa ocho NVIDIA V100 de 32 GB usadas, por unos 4.800 dólares en GPU y placas.
- Ejecuta DeepSeek V4.1 Flash cuantizado a dos bits, con contexto de hasta 524.000 tokens.
- Resume expedientes, extrae fechas e importes y prepara borradores que él revisa.
- Según el autor, cubre entre el 50 % y el 60 % de su trabajo con modelos de lenguaje.
- Las cifras de rendimiento son suyas, no de una evaluación independiente.
El caso, que recogieron Tom’s Hardware y Abogados Contratos, ilustra una pregunta que se hacen muchos despachos: cómo aprovechar los modelos de lenguaje con documentos de clientes sin enviarlos a un servicio de terceros. La respuesta de este abogado ha sido llevarse el modelo a casa, con hardware de centro de datos que ya tiene casi una década.
Qué modelo usa y para qué
El servidor ejecuta DeepSeek V4.1 Flash cuantizado a dos bits, con unos pesos de 248,8 GB. Los expertos del modelo se cargan en la memoria de las GPU y las tablas Engram, que ocupan 110 GB, se quedan en la memoria RAM del sistema. El contexto llega a 524.000 tokens, suficiente para meter de una vez carpetas enteras de documentación. Usa además generación especulativa con un modelo de borrador pequeño para acelerar la respuesta, recuperación aumentada (RAG) y llamadas a herramientas.
El uso es práctico: leer carpetas de documentos, extraer hechos, fechas e importes, preparar resúmenes y generar primeros borradores de textos rutinarios. El abogado accede desde un PC con Windows por SSH a través de una interfaz de tipo chat y asegura que revisa los resultados antes de usarlos. Tiene, además, un segundo servidor con DeepSeek basado en dos NVIDIA DGX Spark.
Rendimiento declarado
Con datos del 5 de noviembre de 2026, el autor informa de hasta 215 tokens por segundo generando código y 118 en redacción jurídica con instrucciones de 1.000 tokens. Con 256.000 tokens de contexto bajan a 160 y 103 tokens por segundo, y la lectura de la instrucción ronda los 2.200 tokens por segundo con contextos de 128.000. En LegalBench, una batería de pruebas de razonamiento jurídico, obtiene 0,716 en 22 tareas, y un 79,9 % en MMLU-Pro.
Son cifras autodeclaradas, sin verificación externa, y con un modelo cuantizado a dos bits, una compresión agresiva que suele restar algo de precisión frente a la versión completa. Para tareas jurídicas, donde un dato mal extraído puede tener consecuencias, la revisión humana que el propio autor dice hacer no es opcional.
Lo que cuesta mantenerlo
El precio de compra es bajo para lo que ofrece, pero el proyecto no ha sido sencillo. El autor relata reinicios por errores del bus PCIe, que desaparecieron al limitar el consumo de cada GPU a 150 W y su frecuencia, una marca de quemadura en un conector de alimentación y errores de memoria que le obligaron a bajar la velocidad de la RAM. Las dos fuentes de alimentación suman 2.800 W y al principio tuvo que conectarlas a circuitos separados de la oficina. Además, la arquitectura Volta de las V100 está al final de su soporte: según el autor, la rama de controladores R580 es la última que la admite.
Para un despacho sin perfil técnico, la alternativa razonable es una nube privada con GPU gestionada por un proveedor europeo, como las que ofrece Cloud Privado, que mantiene los datos bajo control sin obligar a pelearse con fuentes y conectores.
Preguntas frecuentes
¿Cuánto costó el servidor?
Unos 4.800 dólares en GPU y placas, según el autor. Son precios de compra de segunda mano y no incluyen el resto del equipo.
¿Qué modelo de IA ejecuta?
DeepSeek V4.1 Flash cuantizado a dos bits, con un contexto de hasta 524.000 tokens.
¿Por qué no usa un servicio de IA en la nube?
Para procesar expedientes jurídicos sin enviar documentos fuera de su oficina y depender menos de servicios externos.
¿Están verificadas las cifras de rendimiento?
No. Las publica el propio autor en Reddit y GitHub, sin evaluación independiente.
Fuentes: