Machine Learning

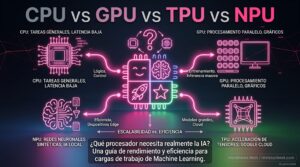
CPU, GPU, TPU y NPU: qué chips están compitiendo por ejecutar la IA

La inteligencia artificial ya no depende de un único tipo de procesador. CPU, GPU, TPU y NPU desempeñan funciones diferentes, desde coordinar un ordenador hasta entrenar grandes modelos o ejecutar IA directamente en un portátil. A ellos se suman FPGA, ASIC especializados y procesadores de infraestructura como las DPU. Entender las diferencias ayuda a explicar por qué la próxima generación

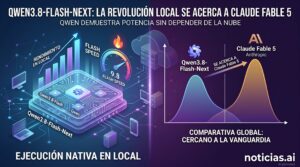
Qwen3.8-Flash-Next se acerca a Claude Fable 5 y puede ejecutarse en local

Alibaba ha publicado Qwen3.8-Flash-Next, un modelo de pesos abiertos que sirve como anticipo de la arquitectura que utilizará la futura familia Qwen4. La cifra que más llama la atención no es únicamente su tamaño: el modelo principal tiene 125.000 millones de parámetros, pero activa alrededor de 6.000 millones por token gracias a su arquitectura Mixture-of-Experts (MoE). En el Agentic Index

Un test con más de 20 modelos de IA deja una advertencia para programadores: más grande no siempre significa mejor

Elegir un modelo de inteligencia artificial para programar basándose únicamente en su número de parámetros puede llevar a resultados inesperados. Una prueba práctica realizada por el desarrollador Rost Glukhov con más de 20 modelos encontró diferencias enormes al generar código y, sobre todo, al producir información estructurada. En su experimento, una versión cuantizada de Qwen 3.5 27B obtuvo una tasa

GPT-6 empieza a tomar forma: lo que sabemos del futuro modelo de OpenAI

OpenAI todavía no ha anunciado GPT-6 ni ha confirmado que Astra, uno de sus próximos modelos, vaya a recibir ese nombre, pero las señales disponibles permiten dibujar con bastante precisión hacia dónde se dirige la siguiente gran generación de su inteligencia artificial. Tras GPT-4, GPT-4o, la familia de razonamiento o1/o3, GPT-5 y el actual GPT-5.6 Sol, el próximo salto parece

Cómo reducir el consumo de VRAM al ejecutar modelos de IA en local

Ejecutar un modelo de lenguaje en local obliga a mirar la memoria de la GPU casi con la misma atención que el número de parámetros. La VRAM no se consume únicamente por los pesos del modelo: también entran en juego la caché KV, el tamaño del contexto, el batch, las activaciones, el formato de cuantización y el motor de inferencia.

WebMCP quiere preparar las webs para una Internet donde naveguen agentes de IA

Google está probando WebMCP (Web Model Context Protocol), una propuesta de estándar web que permite a una página publicar herramientas estructuradas para que los agentes de inteligencia artificial sepan qué pueden hacer y cómo hacerlo. En vez de obligar a un agente a interpretar botones, recorrer el DOM o simular clics, una web puede declarar acciones como buscar productos, rellenar

Scroll al inicio