

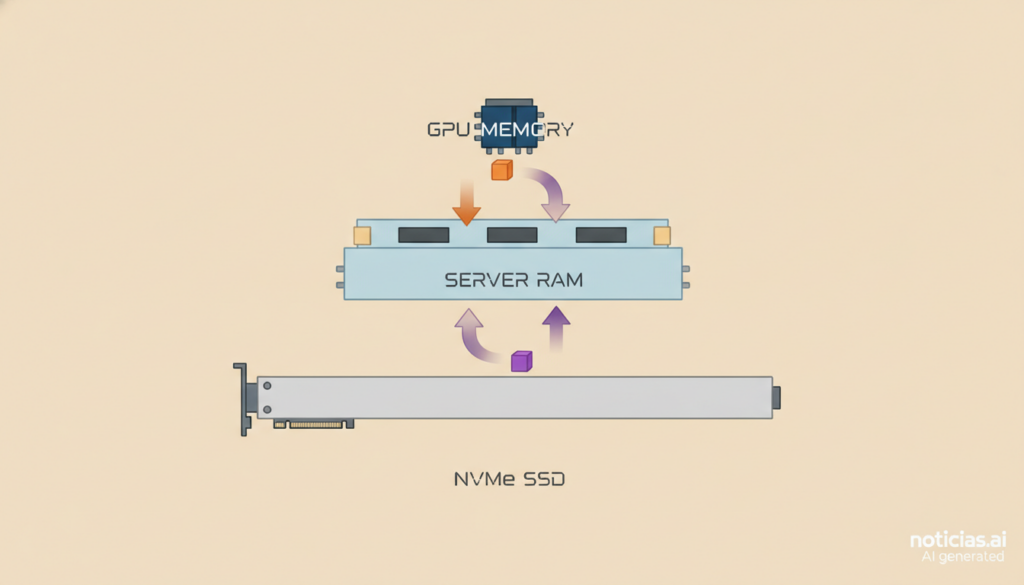
El KV cache offloading consiste en guardar en la memoria del servidor o en un SSD local los bloques de KV cache que la GPU tiene que expulsar, en lugar de tirarlos. Si más tarde llega una petición con el mismo prefijo, el motor de inferencia los recarga y se ahorra volver a calcularlos. vLLM lo ofrece con LMCache (y con un backend nativo de CPU) y SGLang lo integra como HiCache.
Las claves del KV cache offloading en 30 segundos
- La GPU expulsa bloques de KV cache cuando se queda sin memoria; con offloading pasan a la RAM y, después, al SSD.
- Una petición nueva busca su prefijo en todos los niveles, no solo en la GPU.
- En Llama-3-8B, recargar un prefijo de 16.000 tokens desde RAM cuesta unos 0,04 s, frente a 0,8 s de recalcularlo.
- vLLM usa LMCache o su backend nativo; SGLang, HiCache.
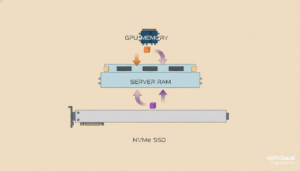
La explicación procede de una infografía animada del bootcamp de vLLM y SGLang de Vizuara, y encaja con lo que describen la documentación de LMCache y el diseño publicado de HiCache. Para entender por qué merece la pena, conviene recordar qué es la KV cache y por qué crece con el contexto: son los tensores de claves y valores que el modelo calcula durante el prefill para cada token y que reutiliza al generar.
Tres niveles de memoria muy desiguales
La idea sale de comparar los niveles de memoria de un servidor de inferencia. La memoria HBM de una GPU es muy rápida, unos 3 TB/s en una H100, pero pequeña: 80 GB que deben alojar los pesos del modelo y la KV cache de todas las peticiones en curso. La memoria RAM del servidor suele llegar a un terabyte o más, y los discos NVMe locales a varios terabytes. Sin offloading, cada bloque que sale de la GPU se pierde, y si el mismo prefijo vuelve (un prompt de sistema largo, un documento sobre el que se hacen varias preguntas, una conversación con muchos turnos), el prefill se repite desde cero.
El mecanismo tiene cuatro piezas:
- Copia al expulsar. Cuando la GPU necesita espacio, los bloques fríos se copian a la RAM en vez de descartarse.
- Desbordamiento. Cuando la RAM se llena, sus bloques más fríos bajan al SSD.
- Búsqueda al llegar. El prefijo de cada petición nueva se compara con los tres niveles, no solo con la GPU.
- Recarga. Los bloques encontrados suben a la GPU y solo se calcula el prefill de los tokens nuevos.
La infografía lo muestra con un caso concreto: la GPU está llena y una petición C necesita seis bloques más. Los seis grupos de bloques de la petición A bajan a la RAM para hacerle sitio, y los bloques más fríos de la RAM pasan al SSD. Cuando A vuelve con el mismo prefijo, sus bloques están en la RAM, suben a la GPU y su prefill se salta; solo se calculan los 512 tokens nuevos.
Las cuentas: 0,04 segundos frente a 0,8
Los números explican por qué compensa con prefijos largos. En Llama-3-8B, con 32 capas, 8 cabezas de clave y valor de 128 dimensiones y precisión de 16 bits, cada token ocupa 128 KiB de KV cache, así que un prefijo de 16.000 tokens son unos 2 GiB. Por un enlace PCIe 5 a unos 50 GB/s, cargarlo desde la RAM lleva alrededor de 0,04 segundos; desde un SSD rápido a unos 7 GB/s, unos 0,3 segundos. Recalcular ese mismo prefill en una H100 cuesta en torno a 0,8 segundos, según la infografía.
Son cifras aproximadas, que dependen del modelo, del ancho de banda real y de la carga del servidor, pero la diferencia es grande: recargar desde la RAM es unas 20 veces más rápido que repetir el prefill, y hasta el SSD gana con holgura. Eso se traduce sobre todo en menos tiempo hasta el primer token (TTFT) y en GPU libre para atender otras peticiones. La ventaja se reduce con prefijos cortos o con cargas en las que los prefijos rara vez se repiten: si nada se reutiliza, el offloading solo añade tráfico.
Cómo lo hacen vLLM y SGLang
En vLLM, la opción más extendida es LMCache, un motor de KV cache de código abierto que, según su documentación, mueve los bloques que no caben de la GPU a la RAM, los escribe de forma asíncrona en disco o en almacenamiento remoto con una política LRU y los vuelve a subir cuando hacen falta. Con disco o almacenamiento externo, la caché sobrevive incluso a reinicios del proceso. vLLM incluye un atajo para activarlo:
vllm serve MODELO --kv-offloading-backend lmcache --kv-offloading-size 5 --disable-hybrid-kv-cache-managerEl valor de --kv-offloading-size se expresa en GiB. vLLM también tiene un backend nativo que, como explica la documentación de Ray Serve, mueve los bloques expulsados a la RAM y los recarga en un acierto posterior, sin dependencias externas.
SGLang lo trae integrado como HiCache, que amplía su RadixAttention con un árbol (HiRadixTree) que registra en qué nivel está cada tramo de KV cache: GPU, RAM del servidor o almacenamiento. Sus autores lo comparan con las cachés L1, L2 y L3 de una CPU: los dos primeros niveles son privados de cada instancia y el tercero puede compartirse entre todas las del clúster mediante backends como Mooncake, 3FS o NIXL. Se activa con --enable-hierarchical-cache, y --hicache-ratio fija el tamaño de la reserva en RAM respecto a la de la GPU. En el blog de LMSYS, el proveedor Novita AI asegura que con HiCache y 3FS el TTFT medio bajó un 56 % y el rendimiento se duplicó en su caso de uso.
Hay matices prácticos. La reserva en RAM debe ser mayor que la caché de la GPU para que aporte algo; la documentación de NVIDIA Dynamo advierte de que, si es menor, el sistema puede empeorar al mover bloques sin parar. Y escribir mucho en el SSD lo desgasta, por lo que algunas implementaciones solo bajan a disco los bloques que se han usado al menos dos veces.
Preguntas frecuentes
¿Qué es el KV cache offloading?
Guardar en RAM o en un SSD local los bloques de KV cache que la GPU expulsa, para recargarlos si llega otra petición con el mismo prefijo en vez de recalcularlos.
¿Cuánto tiempo ahorra?
En el ejemplo de Llama-3-8B con un prefijo de 16.000 tokens, unos 0,04 s desde RAM y 0,3 s desde SSD, frente a 0,8 s de recalcular el prefill en una H100. Son cifras aproximadas.
¿Cómo se activa en vLLM y SGLang?
En vLLM, con --kv-offloading-backend (lmcache o nativo) y --kv-offloading-size. En SGLang, con --enable-hierarchical-cache.
¿Cuándo no compensa?
Con prefijos cortos o cuando las peticiones casi nunca repiten prefijo, porque el ahorro es pequeño y el movimiento de datos tiene coste.
Fuentes: