

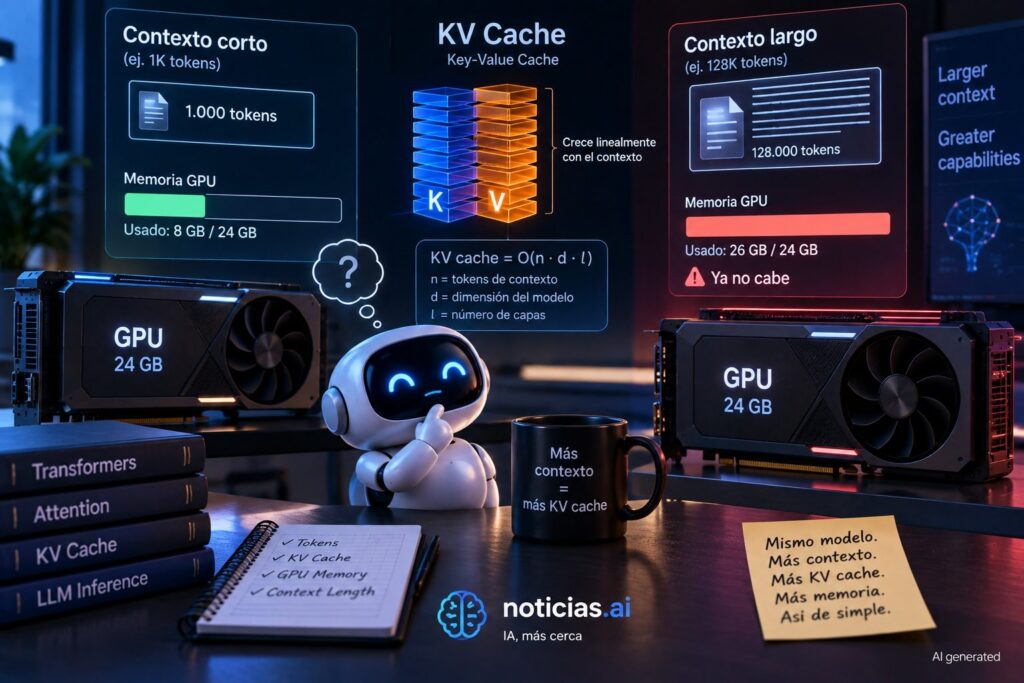
Ejecutar un modelo de inteligencia artificial en local tiene una trampa que no siempre resulta evidente al mirar únicamente el tamaño de sus pesos: la memoria necesaria aumenta conforme crece el contexto, aunque el modelo siga ocupando exactamente lo mismo. Una de las principales responsables es la KV cache, la memoria temporal utilizada por los modelos Transformer durante la inferencia para conservar cálculos de atención ya realizados y evitar repetirlos con cada nuevo token.
Las claves de la KV cache en 30 segundos
- Los pesos de un modelo no aumentan cuando se amplía su ventana de contexto, pero su KV cache sí puede hacerlo.
- En una caché convencional, el consumo crece aproximadamente de forma lineal con el número de tokens almacenados.
- MHA suele necesitar más memoria que GQA al mantener más cabezas de claves y valores.
llama.cpppermite cuantizar por separado las cachés K y V para reducir memoria.- Contexto máximo anunciado y contexto que realmente cabe en una GPU no son necesariamente lo mismo.
La diferencia resulta especialmente importante en inferencia local. Un modelo cuantizado puede cargar perfectamente en una GPU de 16 GB o en la memoria unificada de un Mac y quedarse sin margen cuando el usuario aumenta el contexto de 8.000 a 32.000 tokens.
No ha cambiado el número de parámetros. Tampoco ha aumentado el tamaño del archivo GGUF. Lo que ha cambiado es el estado que debe conservarse durante la inferencia.
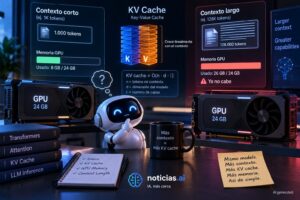
La imagen que acompaña este artículo resume bien el fenómeno con un ejemplo simplificado: unos pesos de 14 GB permanecen constantes mientras una KV cache de aproximadamente 1 GB con 8K de contexto pasa a unos 4 GB con 32K. El modelo que aparentemente cabía dentro de 16 GB puede superar entonces ese límite.
La clave está en entender qué guarda realmente esa caché.
Qué es la KV cache y por qué crece con cada token
Los modelos Transformer utilizan mecanismos de atención para relacionar los tokens que están procesando.
Durante la generación autorregresiva, el modelo produce un token y después utiliza ese resultado como parte de la entrada necesaria para generar el siguiente.
La atención trabaja, de forma simplificada, con representaciones denominadas Query (Q), Key (K) y Value (V). Para los tokens anteriores, las claves y valores ya calculados no necesitan volver a obtenerse desde cero en cada paso.
Ahí aparece la KV cache.
El sistema conserva esos tensores K y V y los reutiliza cuando genera los tokens siguientes. Es, por tanto, una optimización computacional basada en guardar resultados intermedios para evitar recalcular continuamente el pasado.
No debe confundirse con la memoria conceptual del modelo.
La KV cache no decide qué parte de una conversación resulta importante, no crea un resumen de lo ocurrido y tampoco almacena recuerdos de la misma forma que podría hacerlo una base de datos externa conectada a un agente.
Guarda estados numéricos utilizados por el mecanismo de atención.
En una implementación convencional de Multi-Head Attention (MHA) o Grouped-Query Attention (GQA), una aproximación útil al tamaño de la caché es:
KV cache ≈ 2 × capas × cabezas KV × dimensión de cabeza × bytes × tokens
El factor 2 corresponde a los dos conjuntos de tensores que deben conservarse: K y V.
Si se toma como ejemplo un modelo con 32 capas, ocho cabezas KV, dimensión de cabeza de 128 y almacenamiento FP16 de dos bytes, el cálculo por token queda en:
2 × 32 × 8 × 128 × 2 = 131.072 bytes
Es decir, aproximadamente 128 KiB por token.
Al multiplicarlo por el contexto, el efecto empieza a ser considerable.
| Contexto | KV cache aproximada |
|---|---|
| 2.048 tokens | 256 MiB |
| 4.096 tokens | 512 MiB |
| 8.192 tokens | 1 GiB |
| 16.384 tokens | 2 GiB |
| 32.768 tokens | 4 GiB |
| 65.536 tokens | 8 GiB |
| 131.072 tokens | 16 GiB |
Son cifras del ejemplo anterior, no una regla universal para cualquier LLM. La arquitectura del modelo, número de capas, cabezas KV, dimensión, precisión de la caché y técnicas específicas de atención pueden cambiar considerablemente el resultado.
Pero muestran algo importante: duplicar el contexto puede duplicar aproximadamente la memoria destinada a una KV cache convencional.
MHA y GQA cambian mucho la factura de memoria
El número de cabezas KV resulta especialmente importante.
En Multi-Head Attention (MHA) cada cabeza de consulta dispone normalmente de sus correspondientes cabezas K y V.
Grouped-Query Attention cambia esta relación. Varias cabezas de consulta pueden compartir un conjunto menor de cabezas de claves y valores.
Supóngase el mismo ejemplo anterior, pero sustituyendo las ocho cabezas KV por 32.
El consumo pasaría de 128 KiB a unos 512 KiB por token.
Con 32.768 tokens, la diferencia sería aproximadamente esta:
| Configuración del ejemplo | KV cache a 32K |
|---|---|
| 8 cabezas KV | 4 GiB |
| 32 cabezas KV | 16 GiB |
Es una diferencia de cuatro veces.
GQA se ha convertido por ello en una herramienta importante para reducir el coste de memoria y ancho de banda durante la inferencia de los grandes modelos.
Multi-Query Attention (MQA) lleva la idea más lejos compartiendo todavía más las representaciones K y V. Otras arquitecturas recurren a mecanismos diferentes.
Multi-head Latent Attention (MLA), popularizado por DeepSeek, intenta comprimir la información necesaria para la atención en representaciones latentes mucho más pequeñas. Su funcionamiento y cálculo de memoria no deberían reducirse simplemente a la fórmula convencional de una KV cache GQA.
Esta cuestión ha adquirido mucha importancia precisamente porque las ventanas de contexto han pasado de unos pocos miles de tokens a decenas o cientos de miles.
Un diseño de atención que parecía suficientemente eficiente con 4K puede convertirse en un problema de infraestructura con 128K.
Los pesos son solo una parte de la memoria necesaria
Cuando se descarga un modelo local es habitual utilizar el tamaño de sus pesos como referencia para decidir si funcionará en determinado hardware.
Es una primera aproximación útil, pero incompleta.
Durante la inferencia pueden coexistir varios consumidores de memoria:
| Consumo | ¿Crece con el contexto? |
|---|---|
| Pesos del modelo | No |
| KV cache | Sí |
| Buffers de cálculo | Depende |
| Contexto/runtime | Depende |
| Sistema operativo | Independiente del modelo |
| Otras aplicaciones | Independiente del modelo |
| Varias secuencias simultáneas | Puede aumentar mucho el consumo |
Un GGUF que ocupa alrededor de 14 GB no implica, por tanto, que 16 GB de memoria proporcionen necesariamente dos gigabytes libres para cualquier configuración.
Además, GPU discretas y arquitecturas de memoria unificada tienen comportamientos diferentes.
En una tarjeta gráfica dedicada, la VRAM constituye un recurso específico. En Apple Silicon, CPU y GPU utilizan un espacio de memoria unificada, por lo que macOS y otras aplicaciones también necesitan una parte de la memoria física disponible.
Un Mac con 16 GB no equivale a disponer de 16 GB íntegros para pesos, KV cache y buffers del modelo.
Por eso dos usuarios pueden ejecutar el mismo GGUF y obtener resultados diferentes dependiendo del backend, configuración, versión del software, contexto y aplicaciones abiertas.
Cuantizar los pesos no es lo mismo que cuantizar la KV cache
Otro error frecuente consiste en asumir que utilizar un modelo Q4 o Q5 significa que toda la inferencia utiliza esa misma precisión.
La cuantización del archivo del modelo y la precisión utilizada para la KV cache son decisiones distintas.
Una aplicación puede cargar pesos cuantizados a cuatro bits y seguir utilizando una KV cache FP16.
llama.cpp permite controlar independientemente los tipos empleados para K y V mediante las opciones:
-ctk / --cache-type-k
y
-ctv / --cache-type-v
La documentación actual contempla tipos como f32, f16, bf16, q8_0, q4_0, q4_1, iq4_nl, q5_0 y q5_1, aunque el soporte efectivo puede depender del backend y de la configuración utilizada.
Pasar una caché FP16 a Q8_0 puede reducir aproximadamente a la mitad la memoria dedicada a K y V, con cierto overhead propio del formato cuantizado.
Esto puede cambiar completamente la viabilidad de un contexto largo.
En el ejemplo anterior, una caché FP16 que ronda 4 GiB a 32K podría acercarse aproximadamente a la mitad al utilizar una representación de 8 bits, aunque el consumo real debe comprobarse en la implementación concreta.
La reducción no sale gratis.
Cuantizar introduce pérdida de precisión y formatos más agresivos pueden afectar a la calidad. También puede cambiar el rendimiento dependiendo del hardware y del backend.
Por ello Q8_0 resulta una opción razonable para empezar a experimentar cuando el problema principal es la memoria, antes de recurrir a cuantizaciones mucho más agresivas.
¿Es mejor cuantizar V antes que K?
Aquí conviene introducir un matiz respecto a una recomendación habitual.
Puede parecer intuitivo mantener K con mayor precisión porque las claves participan directamente en el cálculo de los scores de atención y reducir primero la precisión de V. Sin embargo, no existe una regla universal que permita afirmar que K siempre sea más sensible que V para todos los modelos y backends.
El impacto depende de la arquitectura, el modelo, la longitud de contexto, el método de cuantización y su implementación.
llama.cpp ofrece precisamente controles independientes para ambas cachés, así que la forma prudente de reducir memoria consiste en probar la configuración con las tareas reales del usuario y comparar calidad y rendimiento.
Una posible progresión práctica sería mantener primero FP16 como referencia, probar después Q8_0 y descender únicamente cuando la memoria adicional resulte realmente necesaria.
La cuantización debe medirse, no darse por inocua.
Más contexto también puede reducir los tokens por segundo
La memoria tampoco es el único coste.
Durante la generación, cada nueva consulta de atención debe trabajar sobre una secuencia que puede hacerse progresivamente más larga.
Con una atención causal convencional, el token que acaba de generarse necesita atender a las claves correspondientes a los tokens anteriores que formen parte de su ventana.
Por eso el rendimiento de decodificación puede empeorar conforme crece el contexto.
Este comportamiento hace que publicar simplemente una cifra como «50 tokens/s» resulte insuficiente para comparar sistemas.
Sería más útil conocer también:
- modelo y cuantización;
- backend y hardware;
- longitud del prompt;
- contexto ya ocupado durante la medición;
- precisión de K y V;
- tamaño de lote;
- número de secuencias simultáneas.
Un equipo puede generar muy rápidamente cuando solo existen unos cientos de tokens en la caché y perder rendimiento cuando debe trabajar con decenas de miles.
También debe distinguirse el prefill, cuando se procesa inicialmente un prompt largo, de la decodificación, cuando se generan posteriormente los tokens uno a uno. Son operaciones diferentes y sus cuellos de botella tampoco tienen por qué coincidir.
La ventana de 128K del modelo no significa que tu equipo soporte 128K
Cuando un fabricante anuncia un modelo con una ventana de contexto de 128K, está describiendo una capacidad de la arquitectura y del modelo bajo determinadas condiciones.
No está prometiendo que cualquier ordenador capaz de cargar sus pesos pueda utilizar esa ventana completa.
Volviendo al modelo hipotético del artículo, con 128 KiB por token, una caché para 131.072 tokens necesitaría aproximadamente 16 GiB en FP16.
Solo la caché.
Si los pesos ocupasen otros 14 GB, el cálculo teórico ya estaría alrededor de 30 GB antes de contar otros buffers y el resto del sistema.
Ese es el motivo por el que aumentar --ctx-size puede convertir una configuración perfectamente funcional en otra que se queda sin memoria.
Y también explica por qué los fabricantes de modelos y los desarrolladores de motores de inferencia dedican tanto esfuerzo a GQA, MLA, cuantización de KV, sliding-window attention, atención dispersa, reutilización de cachés y otras técnicas.
La carrera por ampliar el contexto no consiste simplemente en entrenar al modelo para aceptar más tokens. También hay que conseguir que almacenar y consultar ese pasado resulte económicamente viable.
Para quien ejecuta LLM en local, la consecuencia es mucho más sencilla: antes de descargar un modelo no basta con comprobar cuánto pesan sus parámetros.
Hay que preguntarse también cuánto contexto se pretende utilizar, cuánto ocupará su KV cache y qué margen queda realmente en la memoria del equipo.
Porque el modelo puede seguir pesando exactamente lo mismo mientras su inferencia deja de caber.