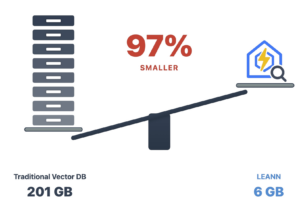


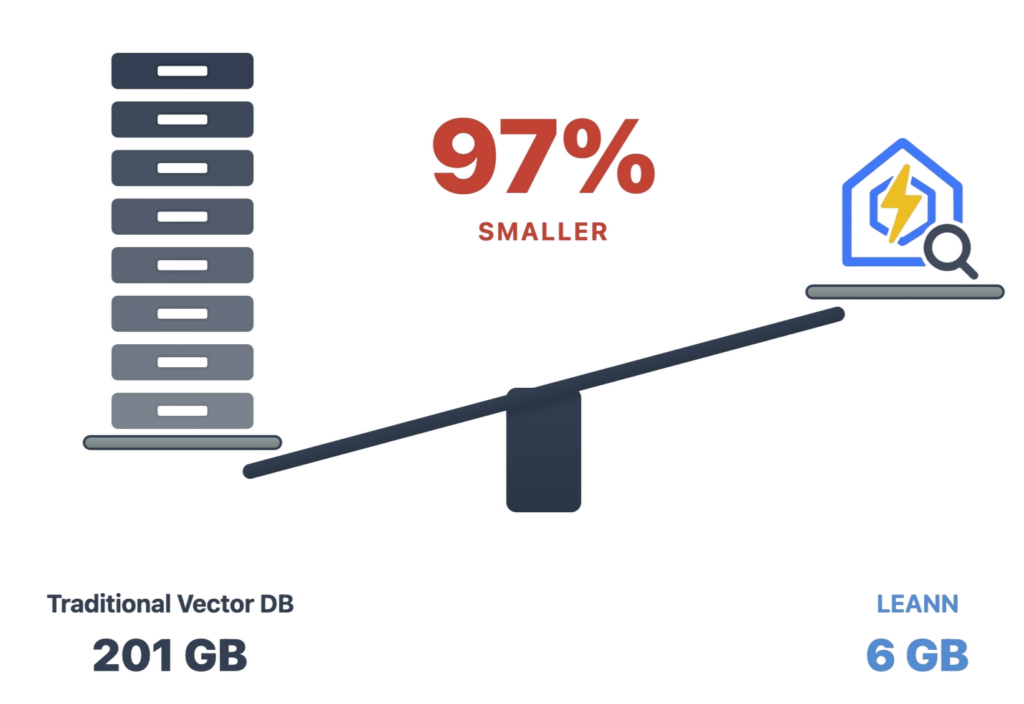
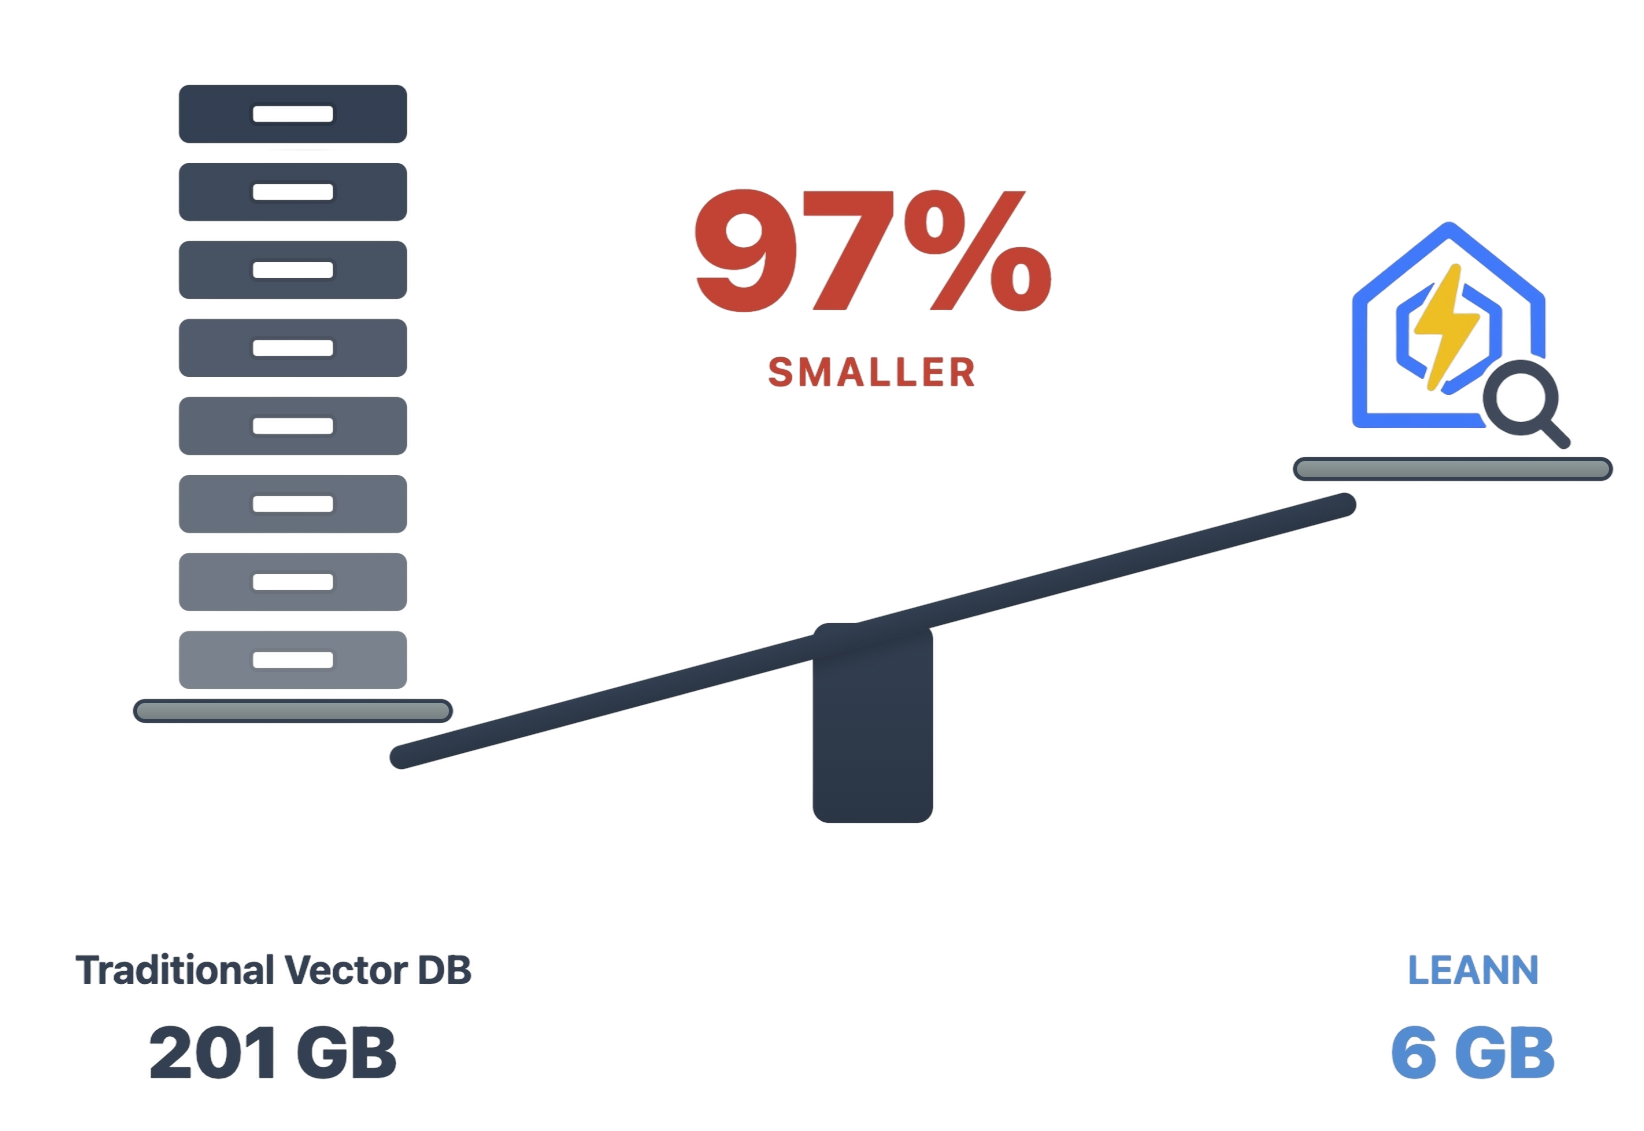
LEANN, un índice vectorial de código abierto desarrollado en el Sky Computing Lab de la Universidad de California en Berkeley, promete reducir hasta un 97 % el espacio que ocupa una base de datos vectorial: según sus autores, indexa 60 millones de fragmentos de texto en 6 GB, frente a los 201 GB de un índice tradicional como FAISS. El truco es no guardar los embeddings, sino recalcularlos cuando hacen falta, lo que permite montar un sistema de búsqueda semántica y RAG en un portátil. El ahorro que muestran sus pruebas tiene, eso sí, un coste en cálculo y en tiempo de respuesta que conviene conocer.
Las claves de LEANN en 20 segundos
- Berkeley publica LEANN con licencia MIT y un artículo presentado en MLSys 2026.
- Según sus pruebas, el índice de 60 millones de fragmentos pasa de 201 GB a 6 GB.
- Ahorra espacio recalculando los embeddings en cada búsqueda en lugar de almacenarlos.
- El artículo habla de un 90 % de acierto en los tres primeros resultados en menos de 2 segundos.
Una base de datos vectorial guarda, para cada fragmento de texto, un vector numérico de cientos o miles de dimensiones (el embedding) y una estructura de grafo para encontrar rápido los más parecidos. Ese índice puede ocupar varias veces más que los propios documentos: la página del proyecto en Berkeley cita que indexar 100 GB de datos puede exigir entre 150 y 700 GB de almacenamiento con los métodos convencionales. Es uno de los motivos por los que el RAG (generación aumentada por recuperación) suele acabar en servidores o en la nube, en un momento en que la IA ya presiona el mercado de discos.
Cómo consigue LEANN ocupar tan poco
La idea central es lo que sus autores llaman recálculo selectivo basado en grafo. LEANN conserva un grafo de proximidad podado, en formato compacto CSR, y descarta los embeddings. Cuando llega una consulta, recorre el grafo y calcula sobre la marcha solo los embeddings de los nodos que visita. La poda mantiene los nodos más conectados, los que funcionan como centros del grafo, y elimina conexiones redundantes para que la estructura ocupe lo mínimo sin perder capacidad de búsqueda.
El proyecto ofrece dos motores. HNSW, el predeterminado, recalcula todo y consigue el mayor ahorro. DiskANN usa vectores comprimidos por cuantización para orientarse en el grafo y recalcula solo para reordenar los mejores candidatos, lo que según el repositorio da el mejor equilibrio entre velocidad y precisión. Estos son los tamaños que publica el propio proyecto:
- Wikipedia, 60 millones de fragmentos: 201 GB con un índice tradicional frente a 6 GB con LEANN, un 97 % menos.
- DPR, 2,1 millones de fragmentos: 3,8 GB frente a 324 MB, un 91 % menos.
- Correo, 780.000 fragmentos: 2,4 GB frente a 79 MB, un 97 % menos.
- Chats, 400.000 fragmentos: 1,8 GB frente a 64 MB, un 97 % menos.
- Historial del navegador, 38.000 fragmentos: 130 MB frente a 6,4 MB, un 95 % menos.
Las cifras se refieren al índice. Para recalcular los embeddings, el sistema necesita seguir teniendo los textos originales, así que la base de conocimiento no pasa de 201 GB a 6 GB en su conjunto: lo que desaparece es la sobrecarga del índice, que en una base vectorial clásica puede superar al propio contenido.
Lo que cuesta no guardar los embeddings
El repositorio asegura que el ahorro no supone pérdida de precisión, pero el artículo científico da más detalle. Publicado en las actas de MLSys 2026, con firmas como Ion Stoica, Matei Zaharia y Joseph E. Gonzalez, afirma que LEANN reduce el índice hasta 50 veces, por debajo del 5 % del tamaño de los datos originales, con una precisión al nivel de los mejores índices y una latencia comparable para aplicaciones de RAG. La página del proyecto en Berkeley concreta que alcanza un 90 % de acierto entre los tres primeros resultados en menos de 2 segundos en pruebas de preguntas y respuestas. Es tiempo que se gasta recalculando vectores en cada consulta, algo que un índice tradicional no necesita.
El otro coste es el cálculo. Cada búsqueda obliga a ejecutar el modelo de embeddings sobre los nodos que recorre, y construir el índice exige calcularlos todos al menos una vez. LEANN funciona sin GPU, con una instalación específica para CPU en Linux, y admite modelos de embeddings con MLX en Mac, pero las propias opciones del proyecto permiten elegir GPU para los embeddings, y su encuesta a la comunidad pregunta si los usuarios quieren aceleración por GPU. Tampoco es local por definición: la configuración por defecto de la herramienta usa la API de OpenAI para generar respuestas, y para mantener todo en el equipo hay que usar modelos locales con Ollama, LM Studio u otros motores compatibles. Quien ya trabaja así puede consultar la guía de RAGFlow en local publicada en Noticias.ai.
RAG sobre correo, chats y código
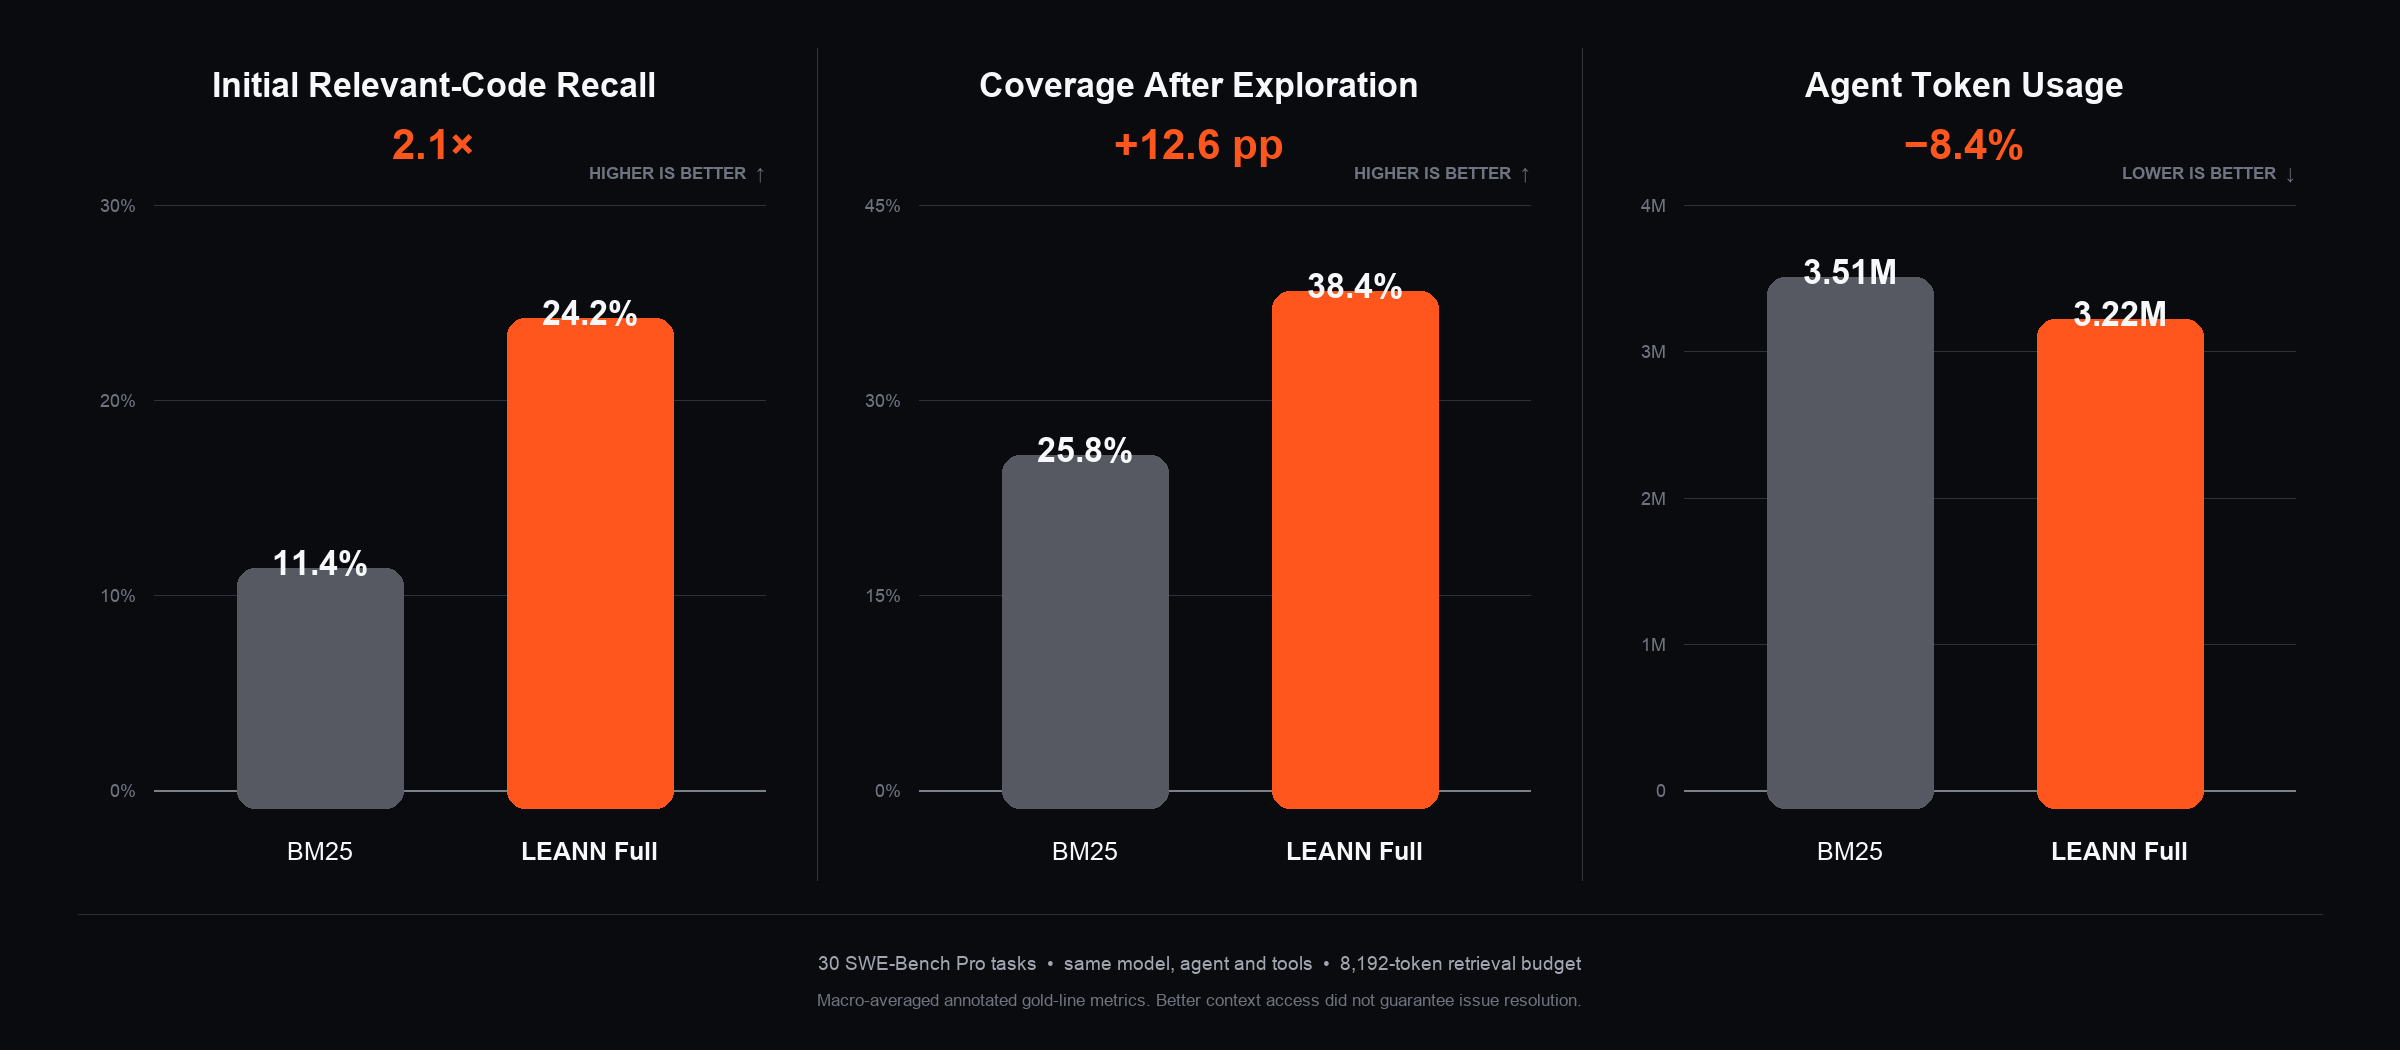
El proyecto incluye ejemplos listos para indexar documentos PDF, TXT y Markdown, Apple Mail, el historial del navegador, conversaciones de WeChat, iMessage, ChatGPT y Claude, y datos en vivo de Slack o Twitter a través de servidores MCP (Model Context Protocol). También ofrece un servicio MCP de búsqueda semántica para Claude Code. Sus autores lo compararon con BM25, la búsqueda clásica por palabras clave, en 30 tareas de SWE-Bench Pro: con el mismo modelo y presupuesto de contexto, el agente encontró el código relevante con el doble de acierto inicial (24,2 % frente a 11,4 %) y gastó un 8,4 % menos de tokens. El propio repositorio advierte de que un mejor contexto no garantiza resolver la incidencia.
LEANN se instala desde PyPI, donde va por la versión 0.3.8, y funciona en Linux, macOS y Windows con Python 3.10 a 3.14:
uv pip install leannPara un usuario con muchos datos personales o un equipo que quiere búsqueda semántica sin montar una base vectorial en un servidor, la propuesta tiene sentido. La frase que circula en redes de que un portátil puede asumir cargas que antes exigían servidores caros es más discutible: lo que cabe en el portátil es el índice, mientras que el cálculo se traslada a cada consulta.
Preguntas frecuentes
¿Qué es LEANN?
Un índice vectorial de código abierto, con licencia MIT, desarrollado en el Sky Computing Lab de UC Berkeley. Permite búsqueda semántica y RAG en local con muy poco almacenamiento.
¿Cómo reduce el espacio un 97 %?
No guarda los embeddings: conserva un grafo podado y recalcula los vectores de los nodos que visita en cada búsqueda. La cifra del 97 % corresponde a sus pruebas con 60 millones de fragmentos de Wikipedia.
¿Pierde precisión o velocidad?
Sus autores afirman que mantiene la precisión de los mejores índices. Según Berkeley, logra un 90 % de acierto entre los tres primeros resultados en menos de 2 segundos, a costa de recalcular embeddings en cada consulta.
¿Necesita GPU o conexión a la nube?
No es imprescindible: funciona en CPU y con modelos locales como Ollama. Por defecto usa la API de OpenAI para generar respuestas, así que hay que configurarlo para que todo quede en el equipo.
Fuentes: