

Vulsar AI ha publicado un benchmark de escritura creativa que compara 24 modelos de inteligencia artificial con referencias de escritores humanos a partir de 475 prompts. GPT 6 Astra encabeza la clasificación general con una tasa de victoria prevista del 87,8 %, ligeramente por encima del 86,6 % de la referencia humana, aunque la diferencia cambia de forma notable cuando se separan escritores profesionales y aficionados.
Las claves del benchmark de escritura creativa de Vulsar en 20 segundos
- Vulsar probó 24 modelos con 475 prompts de escritura creativa.
- GPT 6 Astra logra un 87,8 % de victoria prevista en la clasificación general.
- Los escritores humanos alcanzan el 86,6 % en esa misma clasificación.
- Entre aficionados, Astra llega al 93,9 %, frente al 79,7 % humano.
- Entre profesionales, los escritores obtienen un 99,9 %, frente al 76,2 % de Astra.
El estudio, publicado el 17 de septiembre de 2026, intenta medir una cuestión diferente de los habituales benchmarks de programación, matemáticas o conocimiento. En este caso, Vulsar quiere saber qué relatos escritos por modelos se parecen más a aquello que un grupo amplio de lectores probablemente preferiría.
Para ello, la compañía no utiliza otro modelo de lenguaje como juez. Vulsar ha entrenado un modelo de recompensa específico para escritura creativa con un conjunto amplio y diverso de preferencias humanas. Ese sistema asigna una puntuación a cada historia y convierte posteriormente las diferencias entre relatos en una probabilidad estimada de preferencia.
El resultado debe interpretarse con cierta precisión. Un 87,8 % de tasa de victoria prevista no significa que el 87,8 % de los lectores prefieran siempre ese modelo, ni constituye una puntuación absoluta de calidad literaria. Vulsar explica que se trata de una media de comparaciones entre respuestas a los mismos prompts y que los gustos individuales pueden ser diferentes.
GPT 6 Astra supera por poco a la referencia humana general
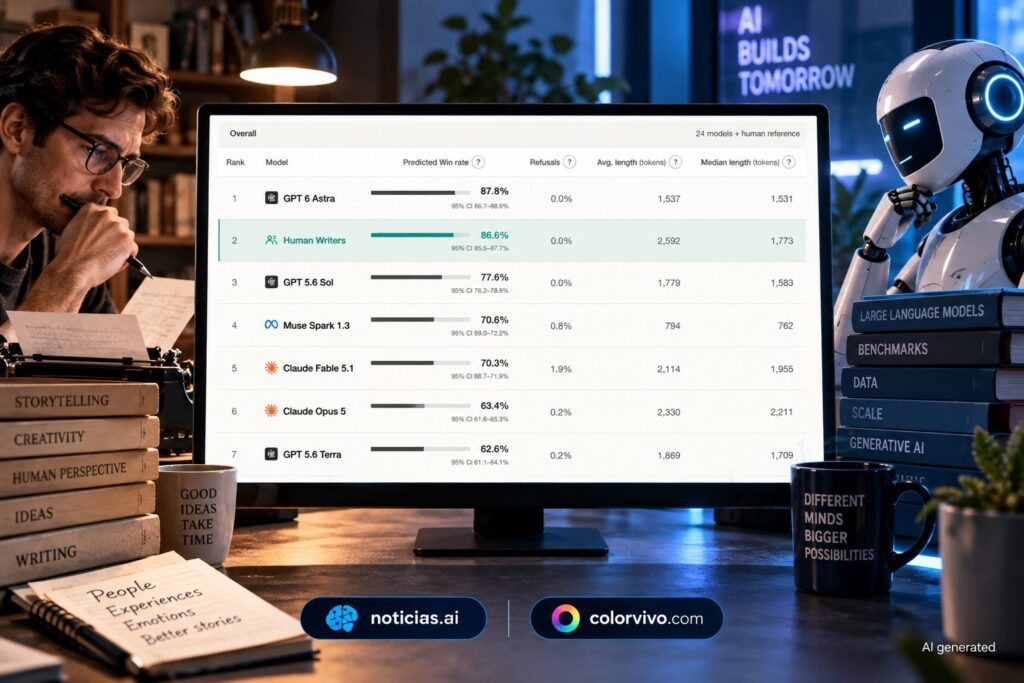
La clasificación general sitúa a GPT 6 Astra en primera posición con un 87,8 % de tasa de victoria prevista, mientras que la referencia de escritores humanos obtiene un 86,6 %. El intervalo de confianza del 95 % es de 86,7-88,9 % para Astra y de 85,5-87,7 % para los escritores humanos.
La diferencia es, por tanto, relativamente pequeña. También resulta importante que Vulsar construya esta clasificación general combinando los prompts utilizados en sus pruebas con escritores profesionales y aficionados. Los dos grupos humanos no reciben exactamente las mismas instrucciones.
| Puesto | Modelo o referencia | Victoria prevista | Longitud media |
|---|---|---|---|
| 1 | GPT 6 Astra | 87,8 % | 1.537 tokens |
| 2 | Escritores humanos | 86,6 % | 2.592 tokens |
| 3 | GPT 5.6 Sol | 77,6 % | 1.779 tokens |
| 4 | Muse Spark 1.3 | 70,6 % | 794 tokens |
| 5 | Claude Fable 5.1 | 70,3 % | 2.114 tokens |
| 6 | Claude Opus 5 | 63,4 % | 2.330 tokens |
| 7 | GPT 5.6 Terra | 62,6 % | 1.869 tokens |
| 8 | GPT 5.6 Luna | 61,8 % | 853 tokens |
| 9 | Kimi K3 | 61,0 % | 852 tokens |
| 10 | Grok 4.6 | 59,3 % | 496 tokens |
Datos de la clasificación general de Vulsar AI. La longitud corresponde a historias satisfactorias y excluye el razonamiento.
A partir de ahí aparece una caída progresiva. GLM 5.3 Flash obtiene un 54,6 %, Qwen3.8 2.4T A95B un 53,9 % e Inkling un 52,3 %. En la parte inferior de la tabla, Gemma 4 31B alcanza un 23,4 %, Qwen3.8 27B un 23,2 %, DeepSeek V4.1 Flash un 19,8 %, DeepSeek V3.2 un 16,5 % y Gemma 4 26B A4B un 10,9 %.
También existe una diferencia importante en la extensión de las respuestas. Los escritores humanos alcanzan una media de 2.592 tokens, frente a 1.537 de GPT 6 Astra. Sin embargo, la longitud por sí sola no determina la posición en el ranking: Claude Opus 5 genera de media 2.330 tokens y queda por debajo de otros modelos que producen textos bastante más cortos.
Los escritores profesionales mantienen una distancia mucho mayor
La fotografía cambia cuando Vulsar separa los resultados profesionales. En esa clasificación, los escritores profesionales alcanzan una tasa de victoria prevista del 99,9 %, mientras que GPT 6 Astra obtiene un 76,2 %.
| Puesto | Modelo o referencia | Victoria prevista | Longitud media |
|---|---|---|---|
| 1 | Escritores profesionales | 99,9 % | 4.528 tokens |
| 2 | Grok 4.6 | 78,5 % | 607 tokens |
| 3 | GPT 6 Astra | 76,2 % | 1.745 tokens |
| 4 | Claude Fable 5.1 | 69,8 % | 2.731 tokens |
| 5 | Muse Spark 1.3 | 64,9 % | 1.031 tokens |
| 6 | Qwen3.8 2.4T A95B | 63,6 % | 1.715 tokens |
| 7 | Claude Opus 5 | 63,3 % | 2.816 tokens |
| 8 | GPT 5.6 Sol | 63,1 % | 2.102 tokens |
| 9 | Kimi K3 | 62,7 % | 1.014 tokens |
| 10 | Qwen3.6 35B A3B | 59,6 % | 1.315 tokens |
Clasificación de Vulsar para los prompts de escritores profesionales.
Grok 4.6 ocupa aquí la segunda posición con un 78,5 %, mientras GPT 6 Astra baja hasta el 76,2 %. Vulsar explica que el modelo de xAI obtiene un salto de ocho posiciones respecto a la clasificación general porque los prompts profesionales contienen instrucciones más detalladas y requisitos específicos.
La longitud de los textos profesionales también es considerablemente mayor. La referencia humana alcanza 4.528 tokens de media y una mediana de 4.313. GPT 6 Astra se queda en 1.745 tokens de media y 1.722 de mediana. Claude Opus 5 llega a 2.816 tokens, mientras Claude Fable 5.1 alcanza 2.731.
El dato no permite concluir que escribir más sea mejor. El benchmark mide la preferencia prevista por el modelo de recompensa, no la extensión del texto. Pero sí muestra una diferencia clara en el volumen de las historias generadas por profesionales frente a las de los modelos.
Los modelos tienen más margen frente a los escritores aficionados
La clasificación de aficionados presenta un escenario distinto. GPT 6 Astra alcanza un 93,9 %, GPT 5.6 Sol llega al 85,2 % y la referencia de escritores aficionados obtiene un 79,7 %.
| Puesto | Modelo o referencia | Victoria prevista | Longitud media |
|---|---|---|---|
| 1 | GPT 6 Astra | 93,9 % | 1.429 tokens |
| 2 | GPT 5.6 Sol | 85,2 % | 1.609 tokens |
| 3 | Escritores aficionados | 79,7 % | 1.581 tokens |
| 4 | Muse Spark 1.3 | 73,5 % | 671 tokens |
| 5 | Claude Fable 5.1 | 70,5 % | 1.791 tokens |
| 6 | GPT 5.6 Terra | 70,2 % | 1.703 tokens |
| 7 | GPT 5.6 Luna | 67,4 % | 759 tokens |
| 8 | Claude Opus 5 | 63,5 % | 2.077 tokens |
| 9 | Kimi K3 | 60,1 % | 769 tokens |
| 10 | GLM 5.3 Flash | 53,6 % | 733 tokens |
Clasificación de Vulsar para los prompts de escritores aficionados.
La diferencia entre Astra y la referencia humana es de 14,2 puntos porcentuales en esta categoría, mucho mayor que los 1,2 puntos de la clasificación general. GPT 5.6 Sol también queda por encima de los aficionados, con una diferencia de 5,5 puntos.
Por debajo de estos modelos, la distancia vuelve a crecer. Claude Fable 5.1 obtiene un 70,5 %, GPT 5.6 Terra un 70,2 %, GPT 5.6 Luna un 67,4 % y Claude Opus 5 un 63,5 %. En la parte inferior, Qwen3.6 35B A3B registra un 30,7 %, Gemma 4 31B un 26,0 %, DeepSeek V4.1 Flash un 17,8 %, Qwen3.8 27B un 15,3 % y Gemma 4 26B A4B un 11,1 %.
El contraste entre aficionados y profesionales es probablemente el dato que más condiciona la lectura del estudio. La primera posición de GPT 6 Astra en la clasificación general no refleja por sí sola cómo se comporta frente a autores con experiencia profesional.
475 prompts y un modelo de recompensa en lugar de un LLM como juez
Vulsar utilizó 475 prompts únicos. Todos los modelos recibieron las mismas instrucciones dentro de cada conjunto y tuvieron que generar una historia corta. Entre los ejemplos publicados aparecen escenarios de ciencia ficción, fantasía y misterio.
En uno de los ejemplos de ciencia ficción, el protagonista es un aprendiz de mantenimiento de una plataforma oceánica que comienza a recibir mensajes de radio sobre accidentes antes de que sucedan. Otro prompt plantea una historia de fantasía alrededor de una cartógrafa real y unos mapas encantados, mientras que el ejemplo de misterio transcurre en un hotel costero durante la década de 1920.
Vulsar desactiva el razonamiento cuando el modelo ofrece esa posibilidad. Cuando no puede desactivarlo, utiliza el nivel de razonamiento disponible más bajo. Las historias humanas sirven como referencia para las comparaciones.
La metodología tiene otra particularidad importante: las negativas y respuestas vacías no cuentan como derrotas. Cuando un modelo no responde a un prompt, esa comparación se excluye y el resto de participantes se compara únicamente con las respuestas disponibles. Vulsar modificó esta regla en la actualización del benchmark publicada el 17 de septiembre.
La tasa de victoria tampoco representa una probabilidad fija frente a cualquier escritor. Vulsar la calcula a partir de las comparaciones disponibles entre modelos y referencias humanas para cada prompt. La propia compañía señala que un 70 % significa una media de comparación de 0,70 dentro de ese conjunto concreto de participantes, referencias y prompts.
Hay además una limitación que afecta directamente a la interpretación del resultado. El modelo de recompensa fue entrenado con preferencias humanas que incluyen valoraciones sobre originalidad. Por eso puede favorecer relatos que parezcan frescos y penalizar textos considerados convencionales o repetitivos. Pero Vulsar no comprueba de forma independiente si las palabras o ideas de una historia son realmente nuevas respecto a textos existentes o a los datos utilizados para entrenar los modelos.
Por tanto, un resultado elevado indica preferencia humana prevista, no demuestra que un modelo haya producido una historia original ni establece una medida universal de calidad literaria.
El benchmark ofrece así una fotografía concreta de la escritura creativa generada por IA en septiembre de 2026. Los modelos de frontera pueden superar a la referencia de escritores aficionados en este conjunto de pruebas, mientras que la diferencia frente a los escritores profesionales es mucho mayor. La clasificación general, por sí sola, oculta buena parte de esa separación.
Preguntas frecuentes
¿Cuántos modelos participaron en el benchmark de Vulsar?
Vulsar evaluó 24 modelos de IA y los comparó con referencias de escritores humanos. El estudio utilizó 475 prompts únicos de escritura creativa.
¿GPT 6 Astra supera a los escritores humanos?
En la clasificación general, GPT 6 Astra alcanza un 87,8 % de tasa de victoria prevista frente al 86,6 % de la referencia humana. Frente a escritores profesionales obtiene un 76,2 %, mientras que la referencia profesional alcanza el 99,9 %.
¿Qué diferencia hay entre escritores profesionales y aficionados?
Los profesionales obtienen un 99,9 % de victoria prevista en su clasificación, frente al 79,7 % de los aficionados. Además, los profesionales generan historias mucho más largas de media: 4.528 tokens frente a 1.581.
¿El benchmark demuestra que la IA escribe mejor que los humanos?
No de forma general. Vulsar mide una preferencia humana prevista mediante un modelo de recompensa y advierte de que el resultado no demuestra que las historias sean originales o únicas. Además, los resultados cambian de forma importante según se compare con escritores profesionales o aficionados.