

Un proyecto de código abierto en C99 ha conseguido ejecutar Kimi K3, un modelo de 2,78 billones de parámetros, en un único procesador y con apenas 8,24 GB de memoria RAM medida. El truco no consiste en comprimir todo el modelo hasta hacerlo caber en un portátil: sus pesos siguen ocupando 1,56 TB en disco y el motor los va leyendo desde el almacenamiento según necesita los expertos de cada token.
Las claves de kimi-k3-in-c en 30 segundos
- El motor está escrito en C99, ocupa 176 KB y funciona sin GPU, BLAS ni un framework de aprendizaje automático.
- Kimi K3 mantiene sus 2,78 billones de parámetros en un checkpoint de 1,56 TB, mientras la ejecución llega a 8,24 GB de RAM.
- Con 8 GB, el proyecto mide 26,5 segundos por token; con 128 GB o más baja a 5,6 segundos.
- El resultado obtenido es idéntico entre los distintos presupuestos de memoria medidos, según las pruebas del proyecto.
- La técnica aprovecha que Kimi K3 es un modelo de mezcla de expertos (MoE) y solo necesita activar una parte de ellos para cada token.
El repositorio kimi-k3-in-c, desarrollado por FareedKhan-dev, plantea una forma distinta de afrontar uno de los problemas habituales de los modelos de lenguaje de gran tamaño: la cantidad de memoria necesaria para mantener sus pesos disponibles durante la inferencia.
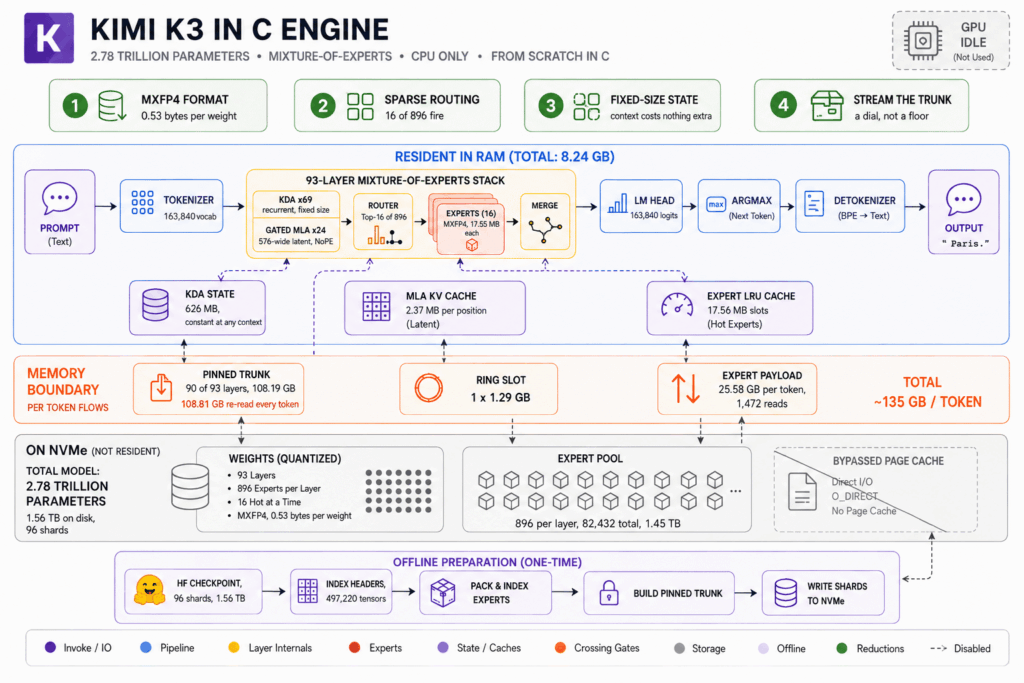
En lugar de intentar cargar los 1,56 TB del checkpoint en RAM, el programa conserva en memoria la parte necesaria del modelo y utiliza el almacenamiento para el resto. La arquitectura de Kimi K3 permite seleccionar un subconjunto de expertos para cada token, de modo que los expertos que no participan en ese cálculo pueden permanecer en el disco y recuperarse cuando hacen falta. El proyecto indica que utiliza 896 expertos con selección de los 16 correspondientes a cada token.
El disco sustituye a una memoria que un portátil no tiene
La diferencia frente a una ejecución convencional es importante. En un sistema con suficiente memoria, los pesos del modelo permanecen disponibles en RAM y el procesador puede trabajar con ellos sin tener que recuperarlos continuamente desde una unidad de almacenamiento. En un portátil de 8 GB eso no es posible con un checkpoint de 1,56 TB.
kimi-k3-in-c convierte esa limitación en una cuestión de velocidad. Según las mediciones publicadas por el proyecto, una máquina con 8 GB necesita unos 26,5 segundos por token. Con 32 GB baja a 24,2 segundos y con 64 GB a 19,8 segundos. A partir de 128 GB, cuando el modelo puede permanecer completamente en memoria en la configuración medida, el tiempo cae a 5,6 segundos por token.
La memoria, por tanto, no determina en estas pruebas si el modelo puede ejecutarse. Determina cuánto tiempo pasa esperando al almacenamiento. El propio proyecto señala que el mismo prompt genera una secuencia de tokens idéntica en los distintos presupuestos de memoria utilizados en sus pruebas. La velocidad cambia, pero no el resultado de la ejecución.
El almacenamiento también se convierte en una pieza determinante. La documentación del proyecto calcula que, con presupuestos pequeños de memoria, el motor puede mover alrededor de 135 GB por token. Por eso una unidad NVMe rápida resulta mucho más relevante que en una aplicación convencional. El sistema no está haciendo que 1,56 TB de datos desaparezcan: está evitando que todos tengan que estar simultáneamente en RAM.
176 KB de código para manejar un modelo de 2,78 billones de parámetros
Otro dato llama la atención por contraste. El motor completo ocupa 176 KB según las mediciones publicadas en el repositorio. No utiliza una GPU, BLAS ni un framework de inferencia tradicional. El código está escrito en C99 y el proyecto está publicado bajo licencia Apache-2.0.
La cifra de 176 KB, sin embargo, no debe confundirse con el tamaño del modelo. El programa es el mecanismo que interpreta los pesos y ejecuta las operaciones; los datos que necesita para hacerlo siguen ocupando 1,56 TB. Esa diferencia permite entender qué aporta realmente el proyecto: una técnica de ejecución que desacopla el tamaño total del checkpoint de la cantidad de RAM disponible.
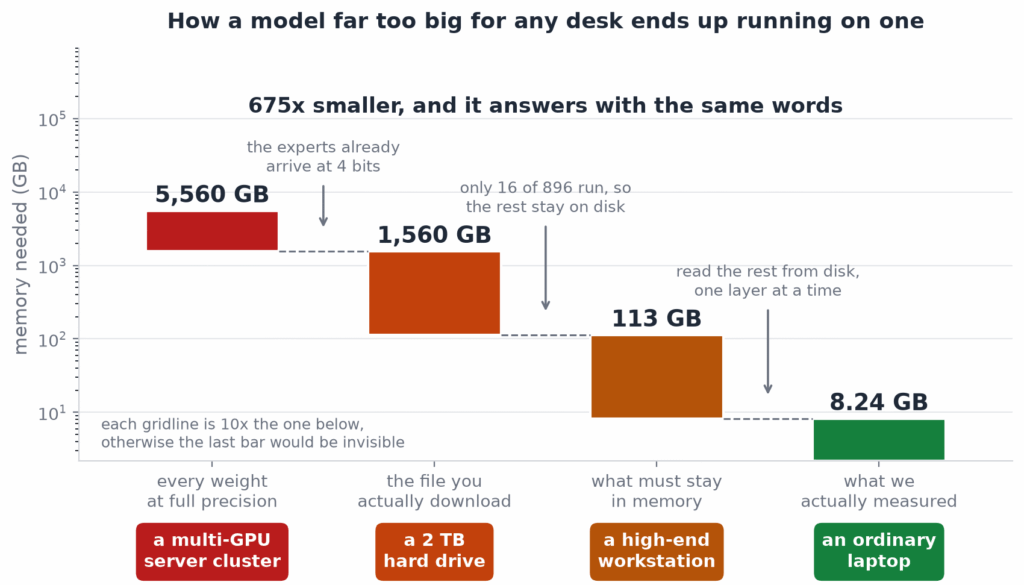
La documentación del repositorio también incluye pruebas destinadas a comprobar que la implementación reproduce los resultados de referencia. El proyecto afirma que las salidas son idénticas entre diferentes presupuestos de memoria y que las pruebas de ejecución pueden verificarse sin descargar el checkpoint completo.
Hay además una precisión importante para quienes quieran probarlo. Kimi K3 se está ejecutando como modelo base y no como un asistente conversacional configurado de fábrica. El propio proyecto y análisis independientes señalan que las salidas deben interpretarse como continuaciones del texto proporcionado, no necesariamente como respuestas de un chatbot con una plantilla de conversación aplicada.
Eso cambia la experiencia práctica, pero no afecta al aspecto técnico que demuestra el proyecto: un modelo de esta escala puede realizar inferencia en una máquina que no dispone de cientos de gigabytes de RAM ni de una GPU dedicada, siempre que se acepte un coste de tiempo muy elevado y se disponga de suficiente almacenamiento.
Una nueva forma de mirar el tamaño de los modelos
El experimento también pone el foco en una distinción que suele perderse cuando se habla de modelos de lenguaje: el número total de parámetros no equivale directamente a la cantidad de parámetros que intervienen en cada token.
Kimi K3 utiliza una arquitectura de mezcla de expertos. Muchos parámetros permanecen disponibles en el conjunto completo del modelo, pero cada token activa solo una parte de esos expertos. Eso permite diseñar sistemas en los que el almacenamiento funciona como una capa adicional de acceso a los pesos.
El resultado no convierte un portátil de 8 GB en una estación de trabajo para ejecutar modelos gigantes a velocidad interactiva. A 26,5 segundos por token, una respuesta relativamente larga puede tardar muchos minutos. Tampoco elimina la necesidad de disponer de alrededor de 1,56 TB para el checkpoint. Lo que cambia es el requisito mínimo de memoria para poder iniciar la inferencia.
Para investigación, experimentación y desarrollo local, esa diferencia puede ser relevante. Hasta ahora, el tamaño de un modelo podía interpretarse de forma bastante directa como una barrera de hardware. Este proyecto demuestra, al menos para Kimi K3 y bajo sus condiciones de prueba, que parte de esa barrera puede trasladarse de la RAM al almacenamiento.
El repositorio ha acumulado ya más de 8.000 estrellas en GitHub y sigue evolucionando con nuevas versiones y mediciones. La versión publicada también incorpora verificaciones para distintos presupuestos de memoria, desde los 8 GB hasta configuraciones mucho mayores.
El cambio más interesante no está en conseguir que un modelo de 2,78 billones de parámetros responda rápido en un portátil. Con las cifras actuales, no lo hace. Está en demostrar que, cuando una arquitectura permite seleccionar solo una fracción de sus parámetros en cada paso, la frontera entre lo que debe permanecer en memoria y lo que puede vivir en almacenamiento se puede mover mucho más lejos de lo que sugieren las especificaciones habituales de un modelo.
Preguntas frecuentes
¿Qué es kimi-k3-in-c?
Es un motor de inferencia escrito en C99 que permite ejecutar Kimi K3 en una CPU sin GPU, cargando los pesos desde el almacenamiento según los necesita.
¿Cuánta RAM necesita Kimi K3 con este proyecto?
Las pruebas publicadas por el proyecto muestran una ejecución con un pico medido de 8,24 GB de RAM. El checkpoint completo sigue ocupando 1,56 TB en disco.
¿Cuánto tarda en generar un token con 8 GB?
La medición publicada para la configuración de 8 GB es de unos 26,5 segundos por token. Con 128 GB o más, el proyecto registra 5,6 segundos por token en la configuración comparada.
¿Por qué puede ejecutarse un modelo tan grande con tan poca RAM?
Kimi K3 utiliza una arquitectura de mezcla de expertos. kimi-k3-in-c aprovecha esa estructura para mantener parte del modelo en memoria y recuperar desde el almacenamiento los expertos necesarios durante la generación.